O blog da AWS
Crie um pipeline de redação de PII sem servidor com Amazon Bedrock Data Automation
por Samantha Stuart e Linda Wang.
As organizações que processam milhares de documentos digitalizados diariamente — que incluem formulários médicos, reclamações de seguros e registros financeiros — enfrentam uma necessidade recorrente de conformidade: a redação de informações de identificação pessoal (PII) antes que os documentos sejam compartilhados com terceiros ou processados a jusante.
A redação manual não escala: consome horas de pessoal, introduz erros humanos e gera exposição de conformidade. Além de um problema de detecção, a redação é também um problema de precisão. Uma única página pode conter vários nomes, datas e endereços, sendo que apenas alguns são sensíveis ao caso de uso. As abordagens tradicionais de redação combinam OCR (optical character recognition) com correspondência de padrões ou modelos personalizados de aprendizado de máquina (ML). No entanto, essas abordagens apresentam limitações quando o texto está degradado, não conseguem expressar facilmente a lógica de negócio em nível de campo e exigem conhecimento de ML para construir e retreinar modelos personalizados à medida que os formatos de documentos mudam.
Nesta publicação, demonstramos como automatizar a detecção e redação de PII em documentos e imagens em escala na AWS. Projetamos um blueprint personalizado para redação de PII e apresentamos uma arquitetura Serverless de processamento em lote com Amazon Bedrock Data Automation (BDA), AWS Step Functions e AWS Lambda. O processo está descrito na Figura 1.
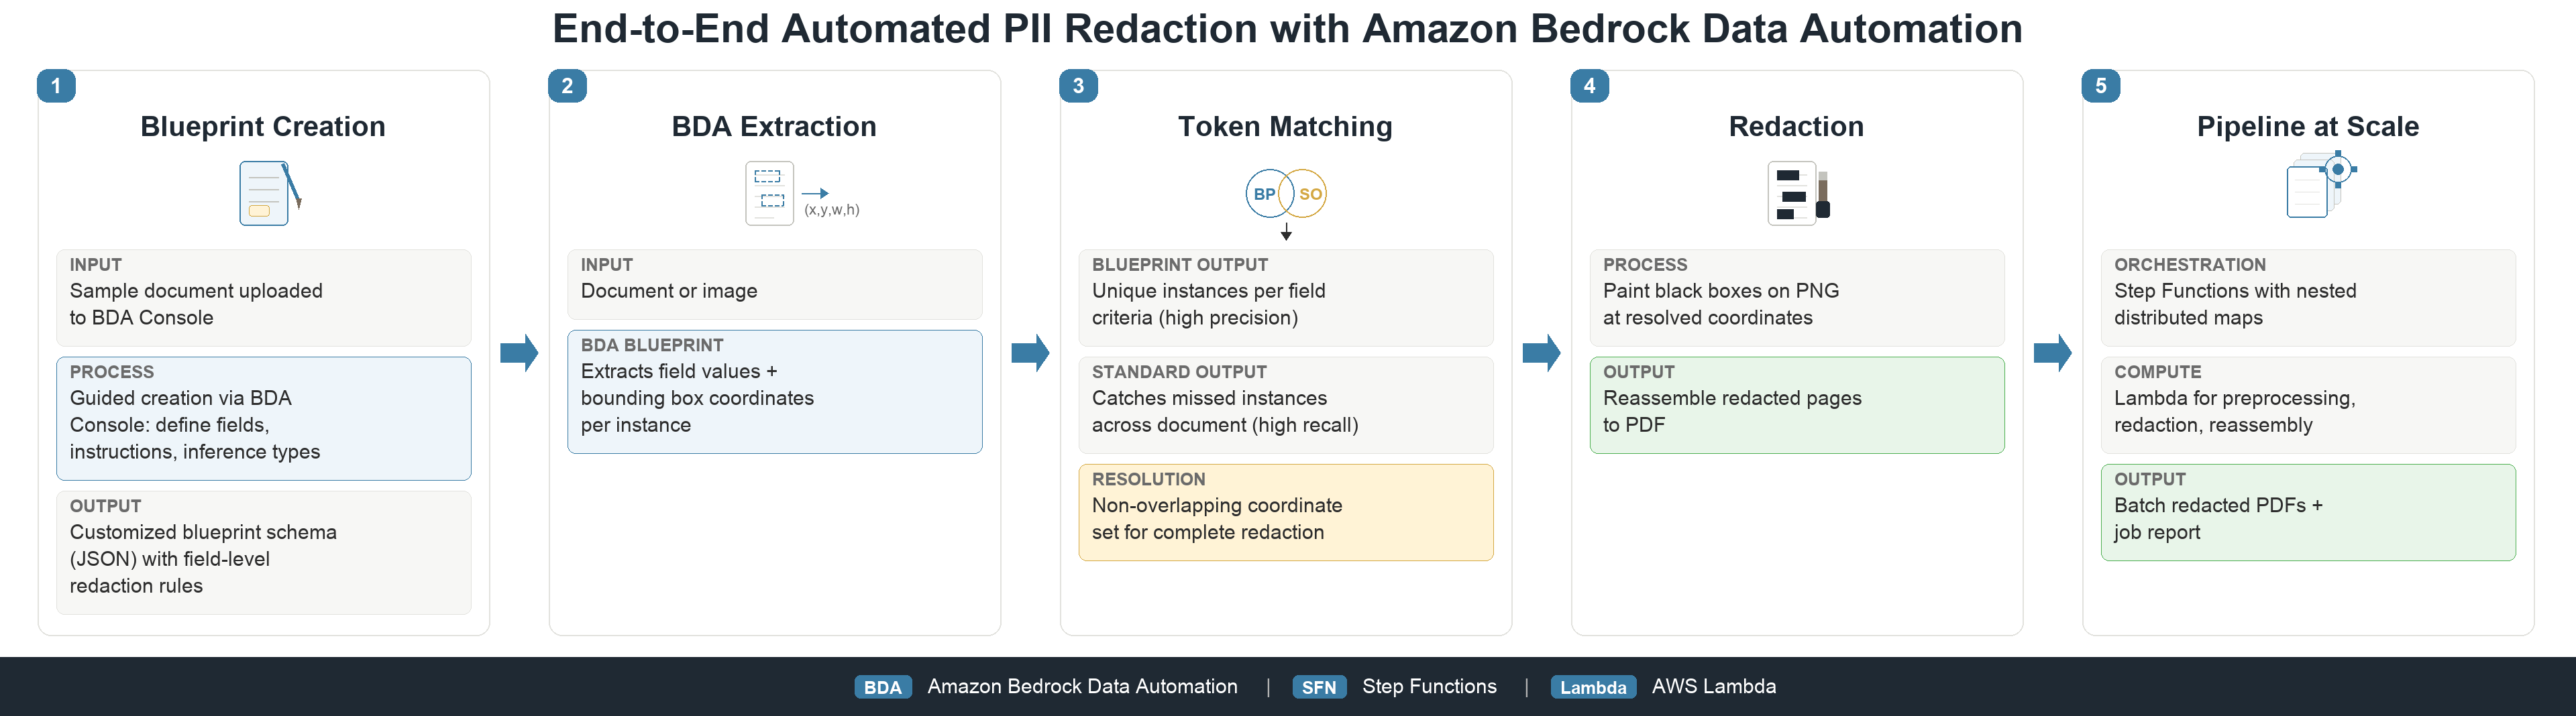
Figura 1: Fluxo de trabalho Serverless de redação de PII de ponta a ponta em escala na AWS
A compreensão de documentos com IA generativa remove as restrições tradicionais de redação. Os modelos de fundação interpretam uma página de documento de forma holística — incluindo layout, rótulos de campo e contexto — e distinguem a qual pessoa um campo pertence com instruções em linguagem natural, em vez de modelos de entidade treinados. O Amazon Bedrock Data Automation é uma oferta do Amazon Bedrock que extrai inteligentemente informações estruturadas de documentos, imagens, áudio e vídeo não estruturados.
Com o recurso de blueprint personalizado do BDA, você declara campos de documento nomeados para extração precisa com instruções em linguagem natural. O BDA retorna o conteúdo do campo desejado, uma pontuação de confiança e coordenadas de caixa delimitadora para cada instância, para pós-processamento a jusante. Ao personalizar um blueprint para seu caso de uso de redação de PII em lote, você usa o BDA como um mecanismo de detecção de PII sob medida para redação em escala.
Para saber mais sobre blueprints e esquemas de saída personalizados do Amazon Bedrock Data Automation, consulte a documentação do Amazon Bedrock Data Automation. Para orientações sobre o gerenciamento de PII em aplicações de IA generativa de forma mais abrangente, consulte a Generative AI Security Scoping Matrix.
Visão geral da solução
A solução tem duas partes: um blueprint BDA personalizado que define o que redactar e um pipeline Serverless que o aplica em escala de lote, seguindo as melhores práticas descritas nesta publicação. O mesmo pipeline Serverless atende a vários casos de uso com blueprints distintos.
Projetando um blueprint de redação de PII
A criação de um blueprint de redação sob medida para um caso de uso de processamento de documentos exige quatro perguntas de escopo: o que é informação sensível, o que não é sensível, onde ela está na página e como removê-la? Nesta publicação, demonstramos o processo por meio do caso de uso de redações de PII em Declarações de Médico Assistente antes do processamento de reclamações a jusante.
Com base no contexto do caso de uso, os requisitos de redação da Tabela 1 foram estabelecidos.
| Pergunta de escopo | Requisito do caso de uso |
|---|---|
| O que é informação sensível? | Nome do paciente, data de nascimento, endereço residencial, informações de contato |
| O que não é informação sensível? | Nome do médico, datas de exame, endereço do consultório, informações de contato do consultório, sintomas e notas médicas |
| Onde está na página? | Distribui-se entre campos de formulário estruturados, escrita manual não estruturada e múltiplas instâncias ao longo do documento |
| Como pode ser removida? | Identificar coordenadas de caixa delimitadora para campos elegíveis, converter o PDF em PNG e aplicar redação por caixa preta nas coordenadas identificadas durante o pós-processamento |
Tabela 1: Requisitos para o blueprint de redação sob medida
Com os requisitos definidos, crie um blueprint BDA pelo AWS Management Console, pela AWS Command Line Interface (AWS CLI) ou pelos SDKs de desenvolvimento, especificando o esquema de blueprint alvo. O console oferece uma opção de criação guiada para gerar um esquema de blueprint a partir de um documento de amostra. O esquema final deve enumerar os campos elegíveis para redação, seu tipo de dado, uma breve descrição em linguagem natural e as transformações aplicáveis — como o formato de data quando se usa o tipo de inferência inferido. O tipo de inferência explícito fornece a extração sem transformações esperadas.
Tome como exemplo o campo de data de nascimento do paciente. É um campo do tipo data, porém nem todas as datas devem ser redactadas no documento — como datas de consulta e de assinatura. A instrução de blueprint indica ao BDA quais subtipos de informação de data extrair, concentrando a extração somente no campo alvo.
A instrução delimita o campo ao paciente, o que permite ao BDA distinguir a data de nascimento das datas de consulta e assinatura, mesmo quando formatos diferentes aparecem na mesma página. O mesmo processo de design mantém o nome impresso e a assinatura do médico assistente fora do conjunto de redação. A Figura 2 apresenta um exemplo de declaração antes e depois da redação com este pipeline de redação de PII. A Figura 3 mostra o blueprint renderizado no console.
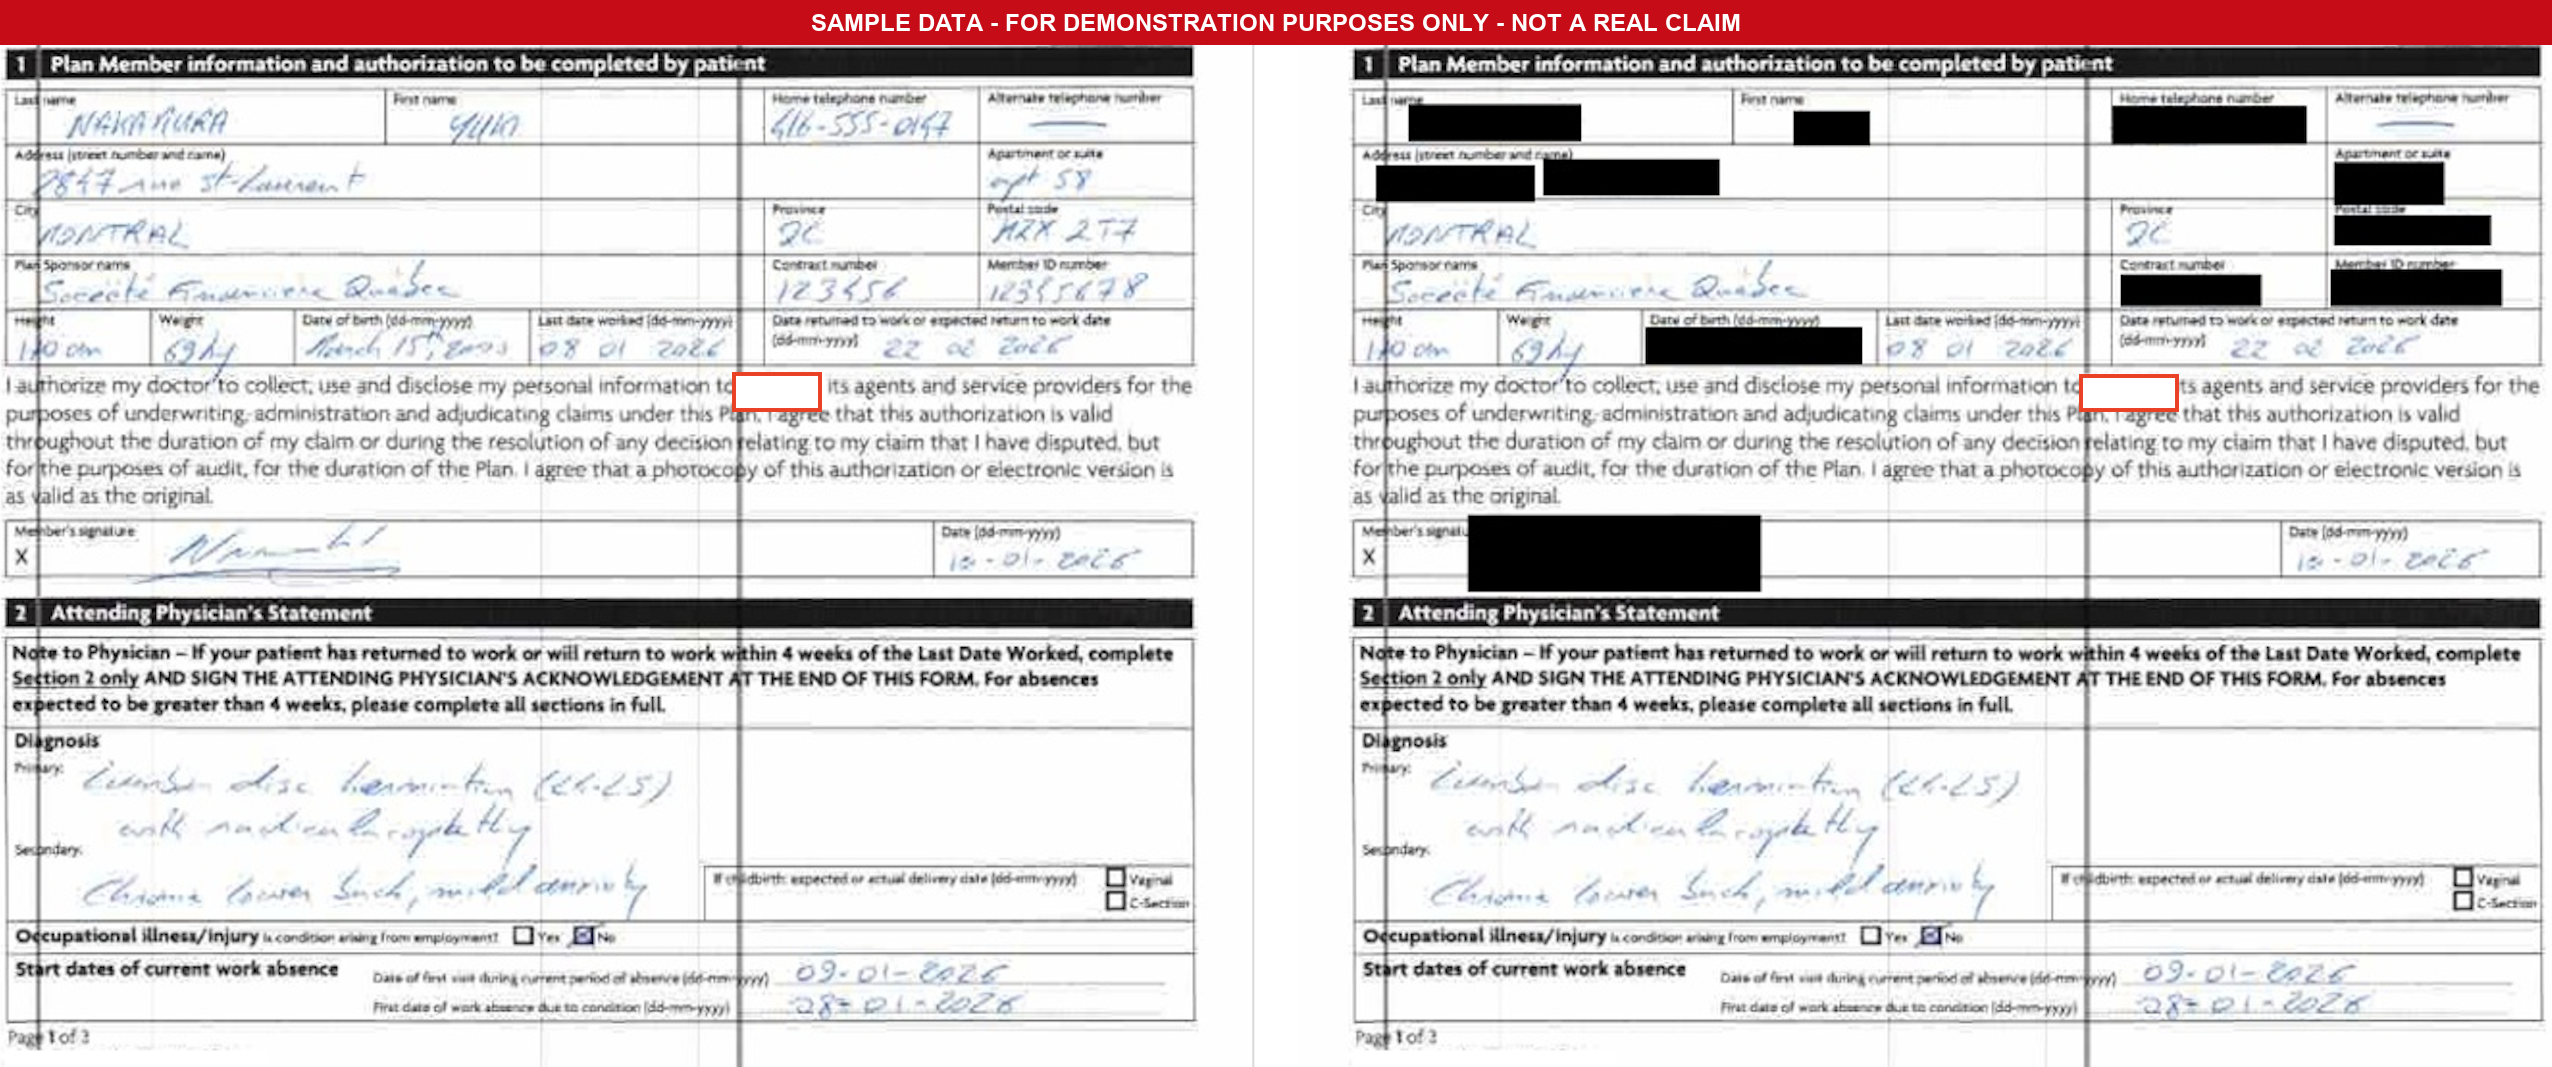
Figura 2: Comparação lado a lado de uma Declaração de Médico Assistente manuscrita antes e depois da redação
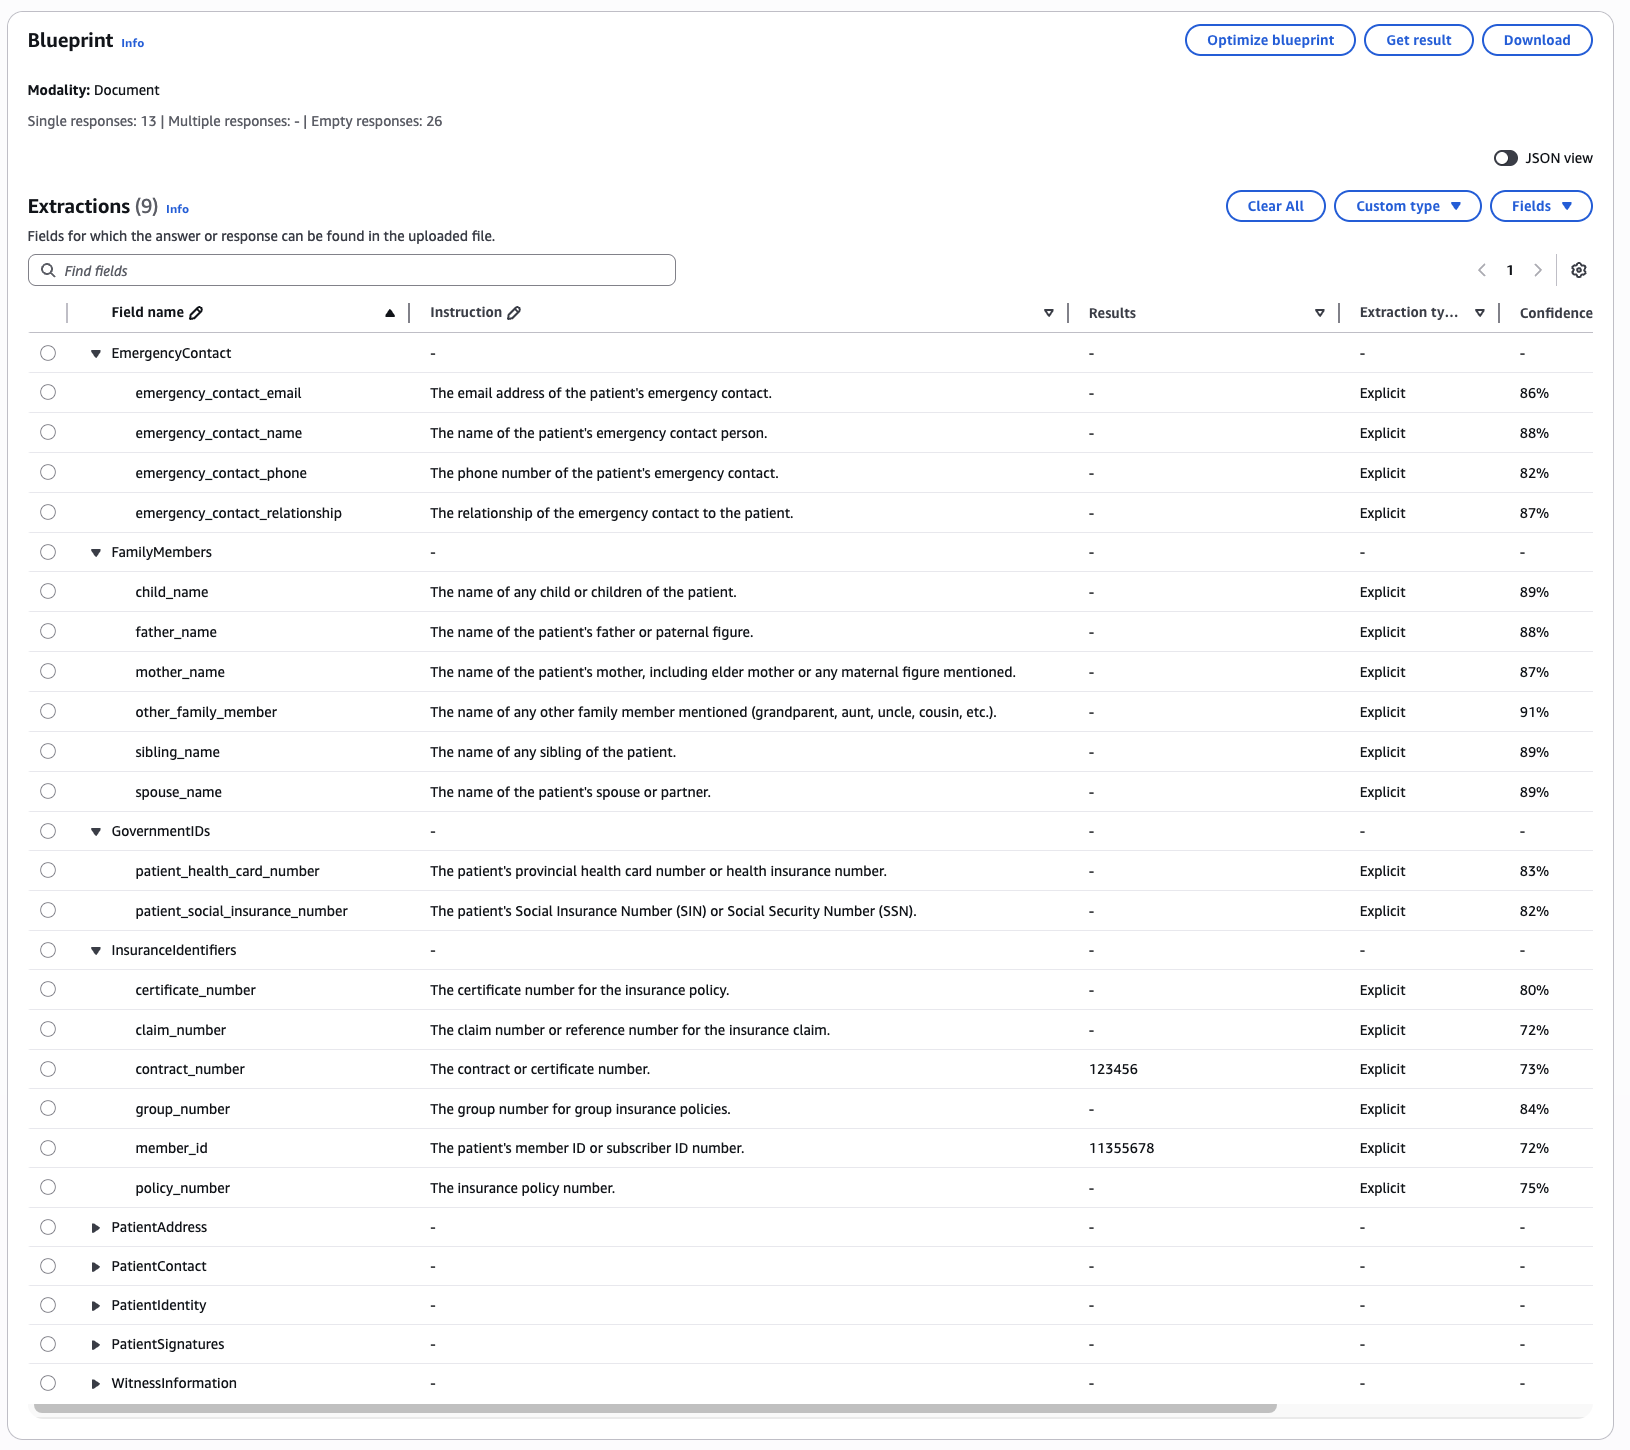
Figura 3: Visualização de extrações no console do Amazon Bedrock Data Automation com os grupos de campos EmergencyContact, FamilyMembers, GovernmentIDs e InsuranceIdentifiers expandidos
O trecho a seguir apresenta um grupo de campos representativo do esquema de blueprint. O esquema completo para a redação de PII de Declarações de Médico Assistente define 37 campos em 9 grupos de campos. Um grupo de campos é uma estrutura que organiza resultados relacionados em um único local na extração.
{
  "PatientIdentity": {
    "type": "object",
    "properties": {
      "patient_first_name": {
        "type": "string",
        "inferenceType": "explicit",
        "instruction": "The patient's given or first name."
      },
      "patient_last_name": {
        "type": "string",
        "inferenceType": "explicit",
        "instruction": "The patient's surname or family name. Look carefully in all sections including signature areas."
      },
      "patient_date_of_birth": {
        "type": "string",
        "inferenceType": "explicit",
        "instruction": "The patient's date of birth in any format (dd-mm-yyyy, mm/dd/yyyy, etc.)."
      },
      "patient_mrn": {
        "type": "string",
        "inferenceType": "explicit",
        "instruction": "The patient's Medical Record Number (MRN)."
      }
    }
  }
}
Cada campo usa inferenceType: "explicit" para extração sem transformação e uma instrução em linguagem natural para delimitar a detecção. O grupo de campos é uma estrutura que organiza resultados relacionados em um único local na extração.
Recomendamos projetar um blueprint BDA sob medida para os requisitos de redação de cada caso de uso de processamento de documentos. A personalização do blueprint depende de resultados obtidos por experimentação sucessiva; a experimentação automatizada adicional é tema de trabalhos futuros.
Na implantação final, o Amazon Resource Name (ARN) do blueprint desejado é usado como parâmetro de entrada, o que permite que a mesma infraestrutura de pipeline em lote seja orquestrada e implantada para escalar múltiplos casos de uso de redação. No pipeline, enviamos uma página de documento por chamada de API ao BDA para concentrar o escopo da requisição de IA generativa em uma página de contexto por vez.
Em uma requisição individual, o BDA processa a página de documento completa para interpretar o layout, os rótulos de campo e o contexto, sem depender de OCR em nível de caractere. Com isso, o BDA localiza um nome de paciente manuscrito que um motor de OCR pode ter dificuldade em transcrever e trata com mais eficácia casos extremos com documentos de entrada de baixa qualidade.
Avaliando um blueprint
Após projetar um blueprint, avalie seu desempenho de redação calculando precisão e recall para instâncias de PII redactadas em relação a documentos de referência redactados por humanos. Analisamos amostras de documentos em seis níveis de qualidade no nosso caso de uso, desde formulários digitados limpos até digitalizações de baixa resolução a 100 pontos por polegada (DPI), conforme a Tabela 2.
| ID do nível | Qualidade do documento | Desafio |
|---|---|---|
| 1 | Formulários digitados limpos | Caso base: campos estruturados, impressão clara |
| 2 | Impresso e enviado por fax | Artefatos de compressão, rotação, desfoque |
| 3 | Fax com baixa qualidade de impressora | Ruído, caracteres parciais |
| 4 | Formulários manuscritos | Caligrafia irregular, espaçamento variável |
| 5 | Manuscrito, impresso e redigitalizado | Degradação combinada de impressão e digitalização |
| 6 | Digitalizações de baixa resolução (100 DPI) | Densidade de pixels reduzida, texto serrilhado |
Tabela 2: Níveis de qualidade de documento testados
Os testes iniciais nas amostras mostraram que o blueprint identificou cada instância de PII no conjunto de 12 documentos (47 páginas) ao menos uma vez, mas ocasionalmente não detectava instâncias repetidas em blocos de texto narrativo e anotações manuscritas do médico. Para aumentar o recall com impacto mínimo na precisão, introduzimos uma segunda passagem de detecção com a saída padrão do BDA e combinamos os resultados por meio de uma etapa de correspondência de tokens no pós-processamento, conforme a Figura 4.
Com uma única chamada de API, o BDA retorna dois tipos de saída:
- Saída personalizada: campos de PII com caixas delimitadoras detectados a partir do blueprint.
- Saída padrão: extração completa incluindo uma caixa delimitadora para cada palavra.
response = self._runtime.invoke_data_automation_async(
    inputConfiguration={"s3Uri": input_s3_uri},
    outputConfiguration={"s3Uri": output_s3_uri},
    dataAutomationProfileArn=profile_arn,
    dataAutomationConfiguration={
        "dataAutomationProjectArn": project_arn,
        "stage": stage,
    },
)
A correspondência de tokens normaliza cada valor de PII detectado em tokens em nível de palavra e, em seguida, varre a saída padrão da página em busca de palavras cuja forma normalizada corresponda a um token de PII. Novas correspondências sem sobreposição são adicionadas ao conjunto final de coordenadas a redactar. Com isso, instâncias repetidas de PII são capturadas onde quer que reapareçam na página, incluindo parágrafos de texto livre e texto manuscrito.
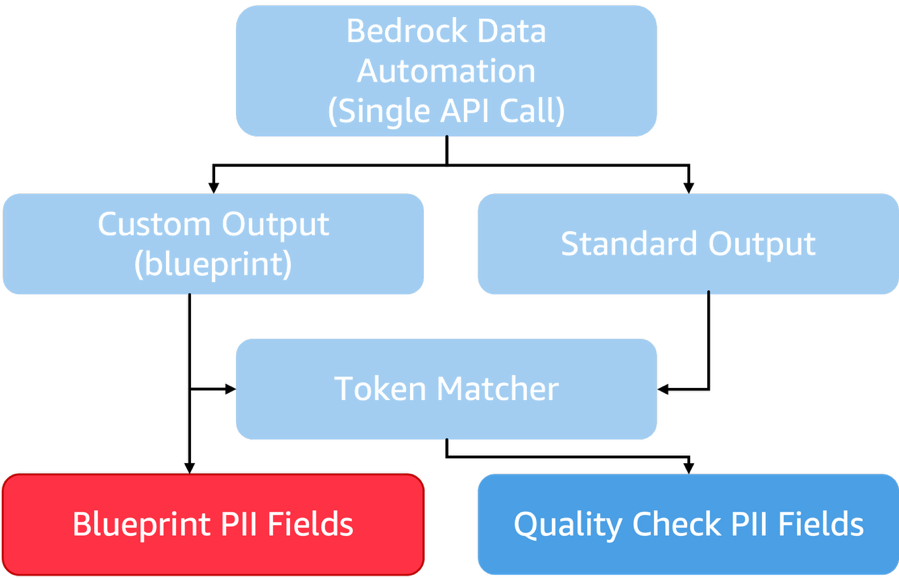
Figura 4: Processo de verificação de qualidade. Uma única chamada de API ao BDA produz saída personalizada e saída padrão, que alimentam um matcher responsável por gerar o conjunto final de campos de PII
Como ambas as passagens se baseiam em uma única chamada de API, a verificação de qualidade aumenta a cobertura sem latência adicional de uma segunda invocação. Avaliamos um conjunto de 12 documentos (47 páginas) nos seis níveis de qualidade da Tabela 2, comparando a saída do pipeline com a referência redactada por humanos. Os resultados constam na Tabela 3.
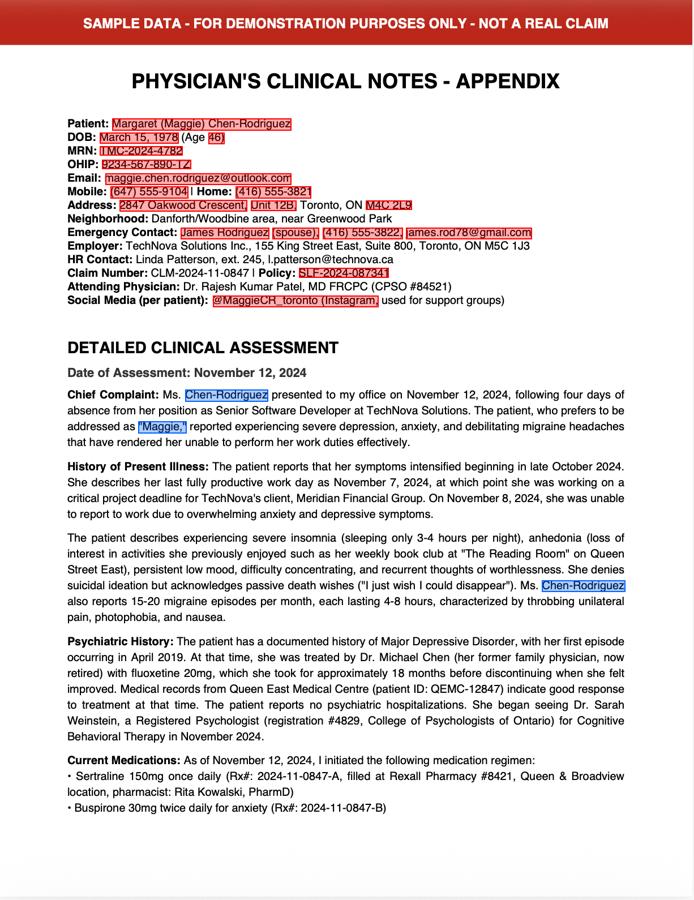
Figura 5: Página de documento onde o nome do paciente é redactado tanto em um campo rotulado quanto em texto narrativo
| Design de redação | Precisão | Recall | Observações |
|---|---|---|---|
| Somente extração por blueprint | 97,0% | 89,3% | Alta precisão em campos declarados explicitamente. PII perdida em blocos de texto narrativo livre |
| Blueprint + saída padrão + lógica de correspondência | 96,5% | 95,2% | A correspondência de tokens aumentou a cobertura de PII repetida em texto narrativo, com pequena redução de precisão por excesso de redação |
Tabela 3: Avaliação de qualidade da redação em relação à referência redactada por humanos para o caso de uso
A adição da saída padrão do BDA como etapa de verificação de qualidade elevou o recall de redação de 89,3% para 95,2%. Na Figura 5, a passagem do blueprint redacta o campo de formulário rotulado com o nome do paciente, indicado em vermelho. A correspondência de tokens na saída padrão captura o mesmo nome onde ele aparece em um parágrafo narrativo mais abaixo na página, indicado em azul. A avaliação do desempenho do blueprint com os escores de confiança do BDA ajuda a encaminhar casos extremos para revisão humana, conforme adequado ao seu caso de uso.
Arquitetura do pipeline
A seguir, demonstramos como construir um pipeline Serverless para levar um blueprint de redação de PII validado ao processamento de documentos em lote. Volumes de produção para redação de Declarações de Médico Assistente podem chegar a aproximadamente 25.000 páginas por noite. Maximizar a concorrência da carga de trabalho de redação com eficiência de custo é uma consideração de design importante.
O pipeline é executado como um fluxo de trabalho Serverless de cinco funções AWS Lambda orquestradas por uma máquina de estados do AWS Step Functions. Múltiplos estados de mapa distribuído do AWS Step Functions distribuem chamadas de API BDA concorrentes em nível de página. Os PDFs de documentos são inseridos por meio de um prefixo do Amazon Simple Storage Service (Amazon S3). Em caso de falhas por limitação de taxa (throttling) no fluxo de trabalho, você pode usar o recurso nativo de redriving do Step Functions para continuar o processamento.
A Figura 6 apresenta a arquitetura do pipeline de produção.
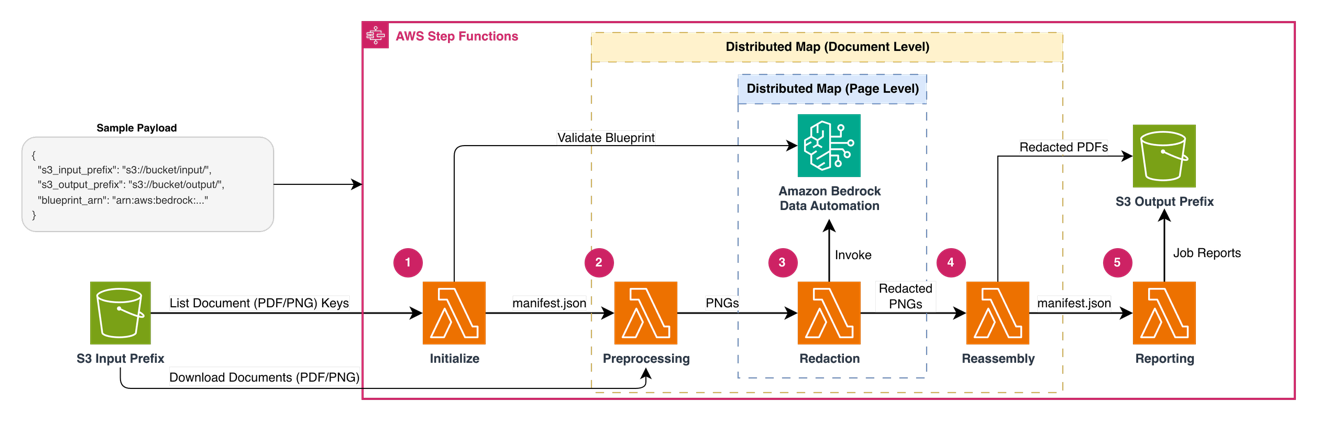
Figura 6: Arquitetura do pipeline Serverless de redação de PII
O diagrama de arquitetura mostra uma máquina de estados do AWS Step Functions orquestrando cinco funções Lambda sequenciais: Initialize (Inicializar), Preprocessing (Pré-processamento), Redaction (Redação), Reassembly (Remontagem) e Reporting (Relatório). Dois níveis de mapas distribuídos aninhados tratam o paralelismo: um mapa externo itera sobre documentos e um mapa interno itera sobre as páginas de cada documento. O Amazon S3 fornece armazenamento de entrada e saída, e o Amazon Bedrock Data Automation processa cada imagem de página para detecção de PII.
Há três entradas para o Step Function:
- Um prefixo de entrada S3 contendo um conjunto de PDFs de entrada não redactados.
- Um prefixo de saída S3 que configura onde gravar os resultados.
- O ARN do blueprint — o ID do blueprint BDA validado para o caso de uso de redação.
O fluxo de trabalho de redação inclui as seguintes etapas:
- Initialize — Valida a entrada, resolve o blueprint, lista os documentos de origem no Amazon S3 e grava um manifesto para o mapa distribuído em nível de documento.
- Preprocess — Converte cada PDF em imagens PNG por página. Documentos de imagem passam diretamente como PNGs de página única.
- Detect and redact — Envia cada imagem de página ao Amazon Bedrock Data Automation para detecção de PII e aplica caixas pretas sobre as coordenadas de cada região detectada.
- Reassemble — Combina as imagens de página redactadas em um único PDF redactado por documento e compila metadados em nível de documento.
- Report — Agrega resumos de documentos em um relatório em nível de trabalho e executa uma verificação de reconciliação.
O Step Functions executa dois níveis de mapas distribuídos aninhados: um mapa externo itera sobre documentos e um mapa interno itera sobre as páginas de cada documento. As configurações de concorrência em nível de documento e de página devem ser compatíveis com a cota de serviço da conta para InvokeDataAutomationAsync. Otimize a concorrência com base nas propriedades da sua carga de trabalho e solicite os aumentos necessários para o seu caso de uso.
Executando a redação
A função Lambda de pré-processamento converte cada documento de entrada em imagens PNG por página. Ela baixa o documento do Amazon S3, detecta o tipo de arquivo, renderiza cada página do PDF em PNG e grava de volta no S3.
A função Lambda de redação executa quatro operações para cada página: invoca o BDA, analisa o resultado, redacta a imagem e faz upload para o S3.
O BDA retorna cada campo detectado com seu valor, pontuação de confiança e caixas delimitadoras em coordenadas normalizadas (esquerda, topo, largura e altura como frações entre 0 e 1). A função converte essas coordenadas em pixels, expande levemente cada caixa para compensar variações e desenha um retângulo preto preenchido sobre a região (Figura 7). A redação sobrescreve os dados de pixel da própria imagem, de modo que o conteúdo coberto não está presente no arquivo de saída. Isso difere das abordagens baseadas em anotação, nas quais o texto original permanece recuperável sob uma camada sobreposta.
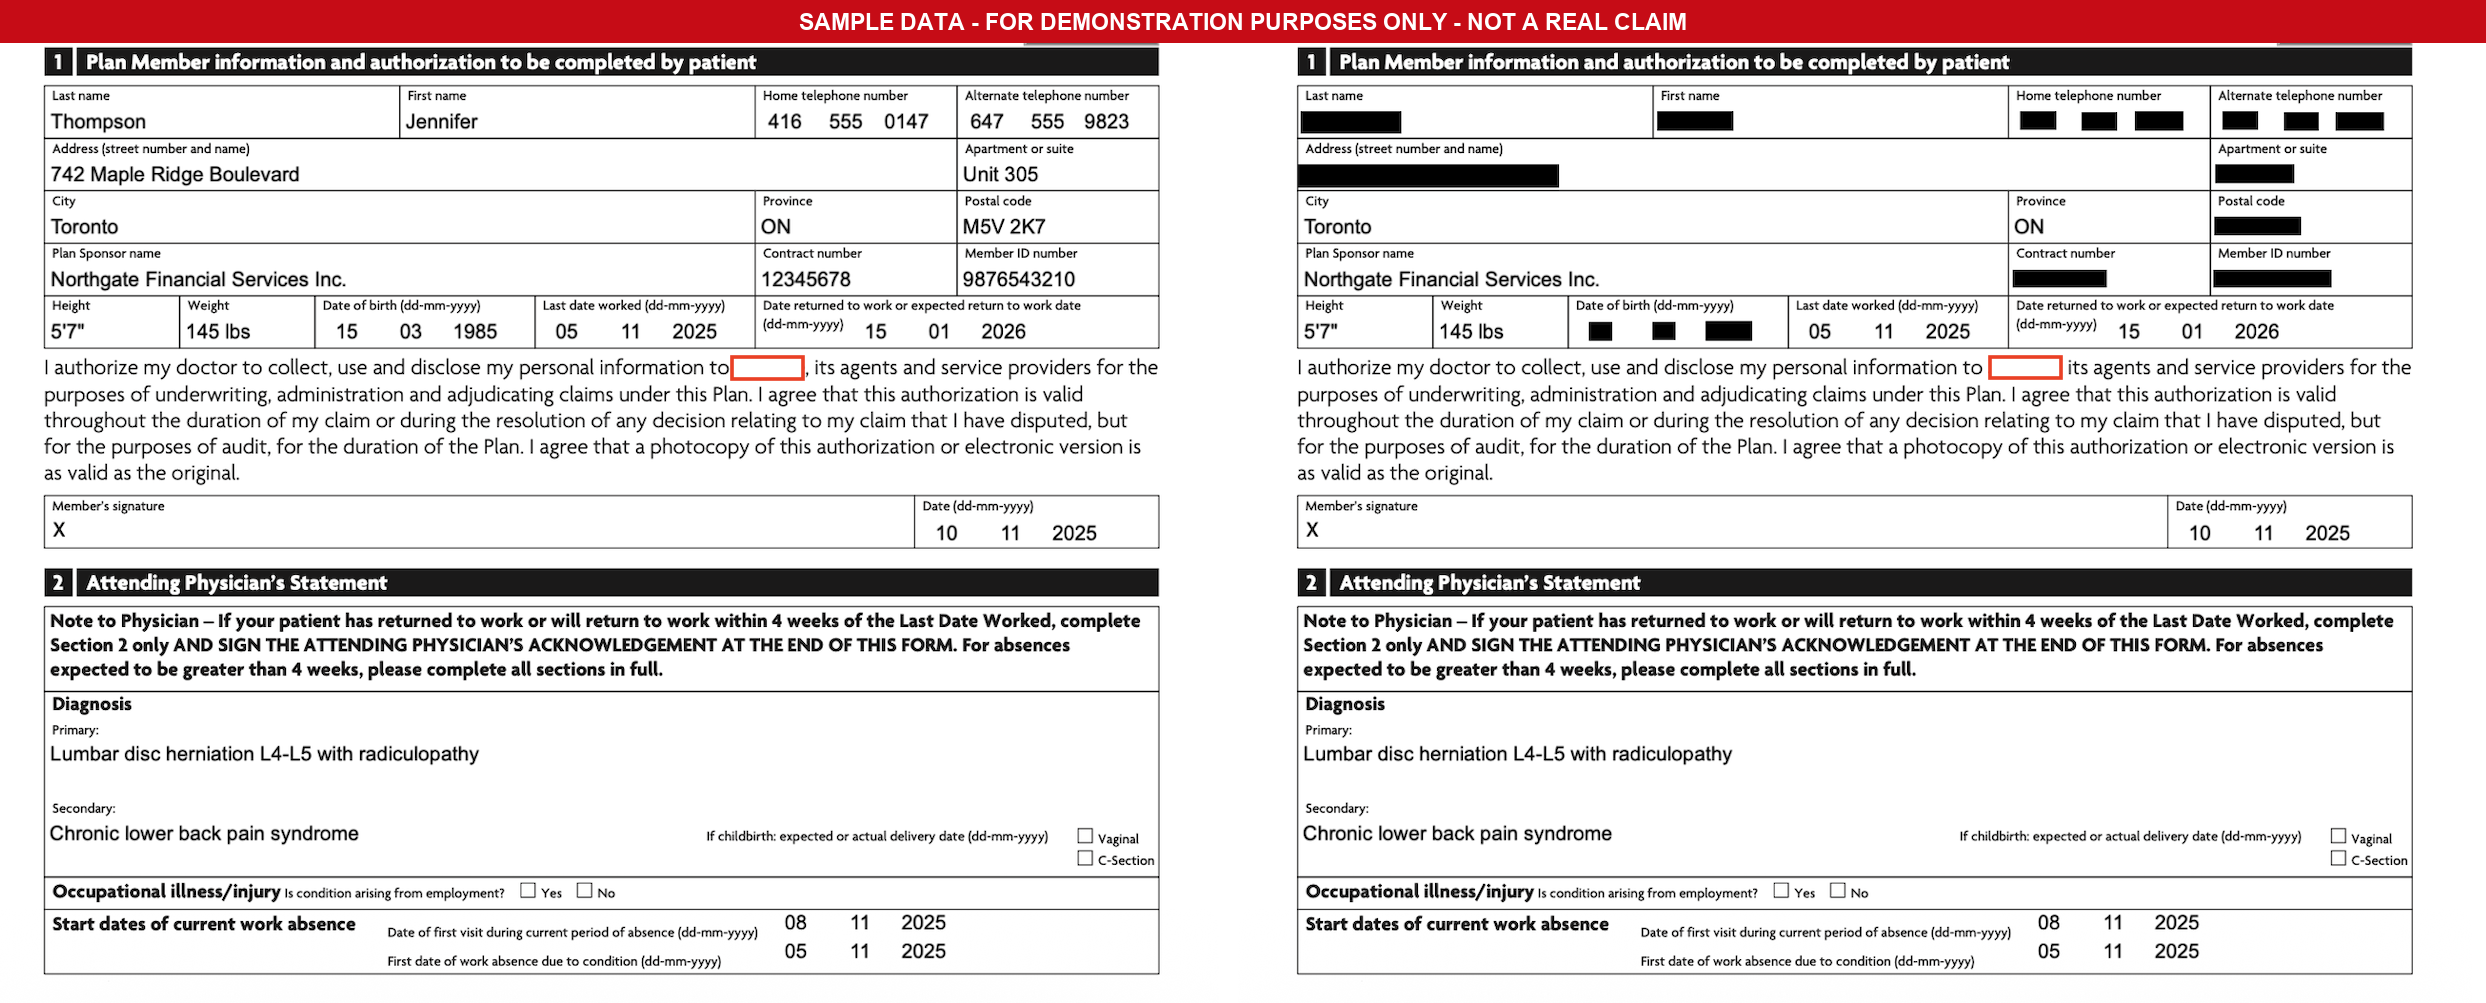
Figura 7: Declaração de Médico Assistente digitada antes e depois da redação
Recuperação de falhas
O pipeline usa uma abordagem em camadas para recuperação de falhas. A primeira camada trata picos de limitação de taxa (throttling) com retry nativo de backoff exponencial com jitter do Step Functions. A segunda camada expõe erros de documentos de entrada corrompidos enquanto os demais continuam o processamento. Em caso de interrupção prolongada, os operadores podem usar o recurso de redriving do Step Functions sem reprocessar o trabalho já concluído.
Duas estratégias de isolamento se aplicam:
- Falhas em nível de documento (por exemplo, PDF corrompido ou erro de remontagem): o pipeline registra as falhas no relatório do trabalho enquanto os demais documentos continuam o processamento. A saída inclui PDFs redactados para as execuções bem-sucedidas com um registro detalhado de falhas.
- Falhas em nível de página (por exemplo, limitação de taxa sustentada que esgota as tentativas de retry): a recuperação usa o redriving nativo do Step Functions. Os operadores identificam quais páginas falharam antes de optar pela recuperação.
Relatórios
Um relatório final do trabalho agrega os detalhamentos por documento, dados de tempo e um resumo de reconciliação. Quando fully_reconciled é verdadeiro, todos os documentos submetidos geraram um PDF redactado. Se todos os documentos falharem, a execução encerra com uma falha dedicada PipelineNoOutput.
{
  "documents_submitted": 12,
  "documents_output": 12,
  "documents_failed": 0,
  "fully_reconciled": true,
  "total_pages": 47,
  "total_pii_fields": 331,
  "total_pii_blueprint_count": 294,
  "total_pii_match_count": 37,
  "average_confidence": 0.8079,
  "pipeline_duration_seconds": 290.7
}
Segurança
O pipeline se baseia nos controles de segurança dos serviços AWS que utiliza:
- Acesso com escopo IAM: cada função Lambda tem uma função AWS Identity and Access Management (IAM) dedicada com privilégio mínimo, com escopo para o bucket do pipeline e apenas as ações necessárias.
- Criptografia em repouso e em trânsito: a criptografia padrão do Amazon S3 protege cada documento e artefato Lambda com AES-256. O pipeline acessa o Amazon S3, o AWS Step Functions e o Amazon Bedrock via Transport Layer Security (TLS).
- Rede privada: as funções Lambda oferecem suporte à implantação em nuvem privada virtual (VPC) por variáveis de infraestrutura como código. Quando ativado, o tráfego para esses serviços permanece fora da Internet pública por meio de endpoints de VPC.
- Auditabilidade: o AWS CloudTrail registra a atividade de API em todo o pipeline, que você pode usar em suas revisões de conformidade.
Escolhendo a abordagem correta de redação de PII
A abordagem de blueprint BDA é adequada para casos em que os documentos estão degradados ou têm formato misto, onde se aplica lógica de negócio em nível de campo (por exemplo, redactar o nome do paciente mas não o do médico) ou onde são necessárias coordenadas de caixa delimitadora em nível de pixel para redação de imagem.
Conclusão
Nesta publicação, mostramos como projetar e construir um pipeline Serverless que detecta e redacta PII em documentos digitalizados com Amazon Bedrock Data Automation, AWS Step Functions e AWS Lambda. Com um blueprint BDA personalizado, você declara campos específicos para redação com instruções em linguagem natural — como o nome de um paciente — sem redactar em excesso nomes de médicos ou conteúdo clínico.
Na avaliação em relação à referência redactada por humanos, a redação por blueprint atingiu 97,0% de precisão, e a adição da saída padrão do BDA como verificação de qualidade por correspondência de tokens elevou o recall de 89,3% para 95,2% em PDFs digitais, formulários manuscritos e faxes de baixa resolução, a partir de uma única chamada de API.
Trate seus blueprints BDA como configuração. Você aponta o mesmo pipeline de produção para um novo tipo de documento ao alterar o esquema do blueprint e o prefixo de entrada S3, o que transforma a implantação em um padrão reutilizável para redação de PII em lote em registros de saúde, formulários de onboarding financeiro, aplicações governamentais ou outras cargas de trabalho com muitos documentos e alta sensibilidade de PII.
Incentivamos você a criar seu primeiro blueprint no console do Amazon Bedrock Data Automation e começar a automatizar sua redação de PII hoje. Para começar, consulte a seção de criação de blueprints na documentação do Amazon Bedrock Data Automation.
Este conteúdo foi traduzido da publicação original do blog em inglês (disponível aqui).
Biografia do Autores
 |
Samantha Stuart é Cientista de Dados e Tech Lead no AWS Professional Services. |
 |
Linda Wang é Consultora Associada no AWS Professional Services. |
Biografia do tradutores
 |
Nicolas Tarzia é Senior Technical Account Manager na AWS, com mais de 13 anos de experiência, com ampla experiência em arquitetura cloud, engenharia e design de software. Atualmente está habilitando empresas do ramo de ISV (Independent Software Vendors) simplificando a operação na nuvem e otimizando os custos em cloud. Sua área de interesse são tecnologias serverless. https://www.linkedin.com/in/nicolastarzia |
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |