AWS 기술 블로그
AWS 기반 EDA 환경으로 Rebellions의 차세대 AI NPU 개발 가속화하기
첨단 반도체를 개발하려면 수많은 Logic Simulation을 반복하고, DFT(Design for Test)와 Physical Design 같은 높은 컴퓨팅 성능이 필요한 EDA(Electronic Design Automation) 작업을 수행해야 합니다. 설계 규모와 검증 범위가 커질수록 필요한 CPU 코어와 메모리, 공유 스토리지 처리량도 함께 증가합니다. 필요한 시점에 충분한 인프라를 확보하지 못하면 EDA 도구의 실행 시간과 작업 대기열이 길어지면서 전체 개발 일정에 영향을 줄 수 있습니다.
AI 추론용 NPU를 개발하는 Rebellions는 반도체 설계 과정의 Design Verification(DV)과 Physical Design(PD) 업무에 AI Transformation(AX)을 적용해 엔지니어 생산성을 약 3배 향상시켰습니다. 그러나 엔지니어링 업무의 생산성이 높아진 후에도 상대적으로 긴 EDA 도구의 실행 시간이 전체 개발 속도를 제한하며, 새로운 병목으로 부각됐습니다.
Rebellions는 이러한 병목을 해소하고 설계 개발 전반의 생산성을 더욱 높이기 위해, 실제 NPU 개발 워크로드를 기반으로 AWS 환경에서의 EDA 성능과 확장성을 검증했습니다.
이 글에서는 AWS ParallelCluster와 Amazon FSx를 활용한 EDA 환경 구성과 함께, Logic Simulation, DFT, Physical Design 워크로드에서 확인한 성능 개선 결과를 소개합니다.
Rebellions 소개
Rebellions는 AI 추론용 NPU 칩부터 컴파일러를 포함한 소프트웨어까지 자체 개발하는 AI 추론 전용 풀스택 팹리스 스타트업입니다. 대한민국 정부가 조성한 국민성장펀드 1호 투자 기업으로서 국가 소버린 AI 인프라 생태계를 선도하고 있으며, APAC과 중동, 유럽 등 글로벌 시장으로 사업을 확장하고 있습니다.
데이터센터 인프라용 1세대 NPU인 ATOM을 성공적으로 상용화해 대규모 트래픽이 발생하는 SKT의 ‘에이닷’ 통화요약 서비스 등에 적용했으며, 대한민국 최초의 NPU-as-a-Service를 구축했습니다.
2세대 NPU인 Rebel100은 최고의 performance-per-watt와 한국 최초의 페타플롭스급 성능을 기반으로, 에이전틱 AI 시대에 필요한 CPU–NPU 통합 최적화와 서버 단위에서 토큰 팩토리 단위까지 확장 가능한 아키텍처를 제공합니다. 이를 통해 다양한 차세대 AI 워크로드에 유연하게 대응할 수 있으며, 2026년 초 양산에 착수해 2026년 하반기부터 다양한 고객 환경에 본격 적용될 예정입니다.
향후에는 더욱 다양하고 복잡해지는 AI 워크로드에 최적화된 성능을 제공하기 위해, 차세대 메모리 중심 구조(memory-centric architecture)와 HW–SW co-design을 중심으로 기술 및 제품 아키텍처의 발전 방향을 지속적으로 모색해 나갈 계획입니다.
NPU 개발의 다음 병목, EDA 실행 시간
EDA 워크로드는 작업에 따라 필요한 자원의 특성이 다릅니다. Logic Simulation은 기능과 설정, 난수 seed에 따라 생성되는 다수의 독립 작업을 제한된 시간 안에 처리해야 합니다. DFT와 Physical Design은 높은 CPU 성능뿐 아니라 대용량 메모리와 빠른 파일 접근 성능을 요구합니다.
이러한 작업을 고정된 온프레미스 인프라에서 수행하면 두 가지 문제가 발생합니다. 먼저 프로젝트의 피크 수요를 기준으로 장비를 구매하면 평상시에는 유휴 자원이 생깁니다. 반대로 평균 수요에 맞춰 장비를 구성하면 regression이나 설계 마일스톤처럼 작업이 집중되는 시기에 대기 시간이 길어집니다.
고성능 서버 한 대를 추가하는 것만으로 모든 문제를 해결할 수 없습니다. Logic Simulation처럼 독립 작업이 많은 워크로드에는 동시 처리 용량이 중요하고, Physical Design에는 높은 클록과 충분한 메모리를 갖춘 인스턴스가 필요합니다. 여러 작업이 공통 설계 데이터와 라이브러리에 동시에 접근하므로 공유 스토리지와 네트워크 성능도 함께 확보해야 합니다.
Rebellions는 EDA 작업별로 적합한 컴퓨팅 자원을 선택하고, regression이나 설계 마일스톤처럼 작업이 집중되는 시점에 대규모 실행 용량을 확보할 수 있는지를 확인하기 위해 AWS 기반 EDA 환경을 검증했습니다.
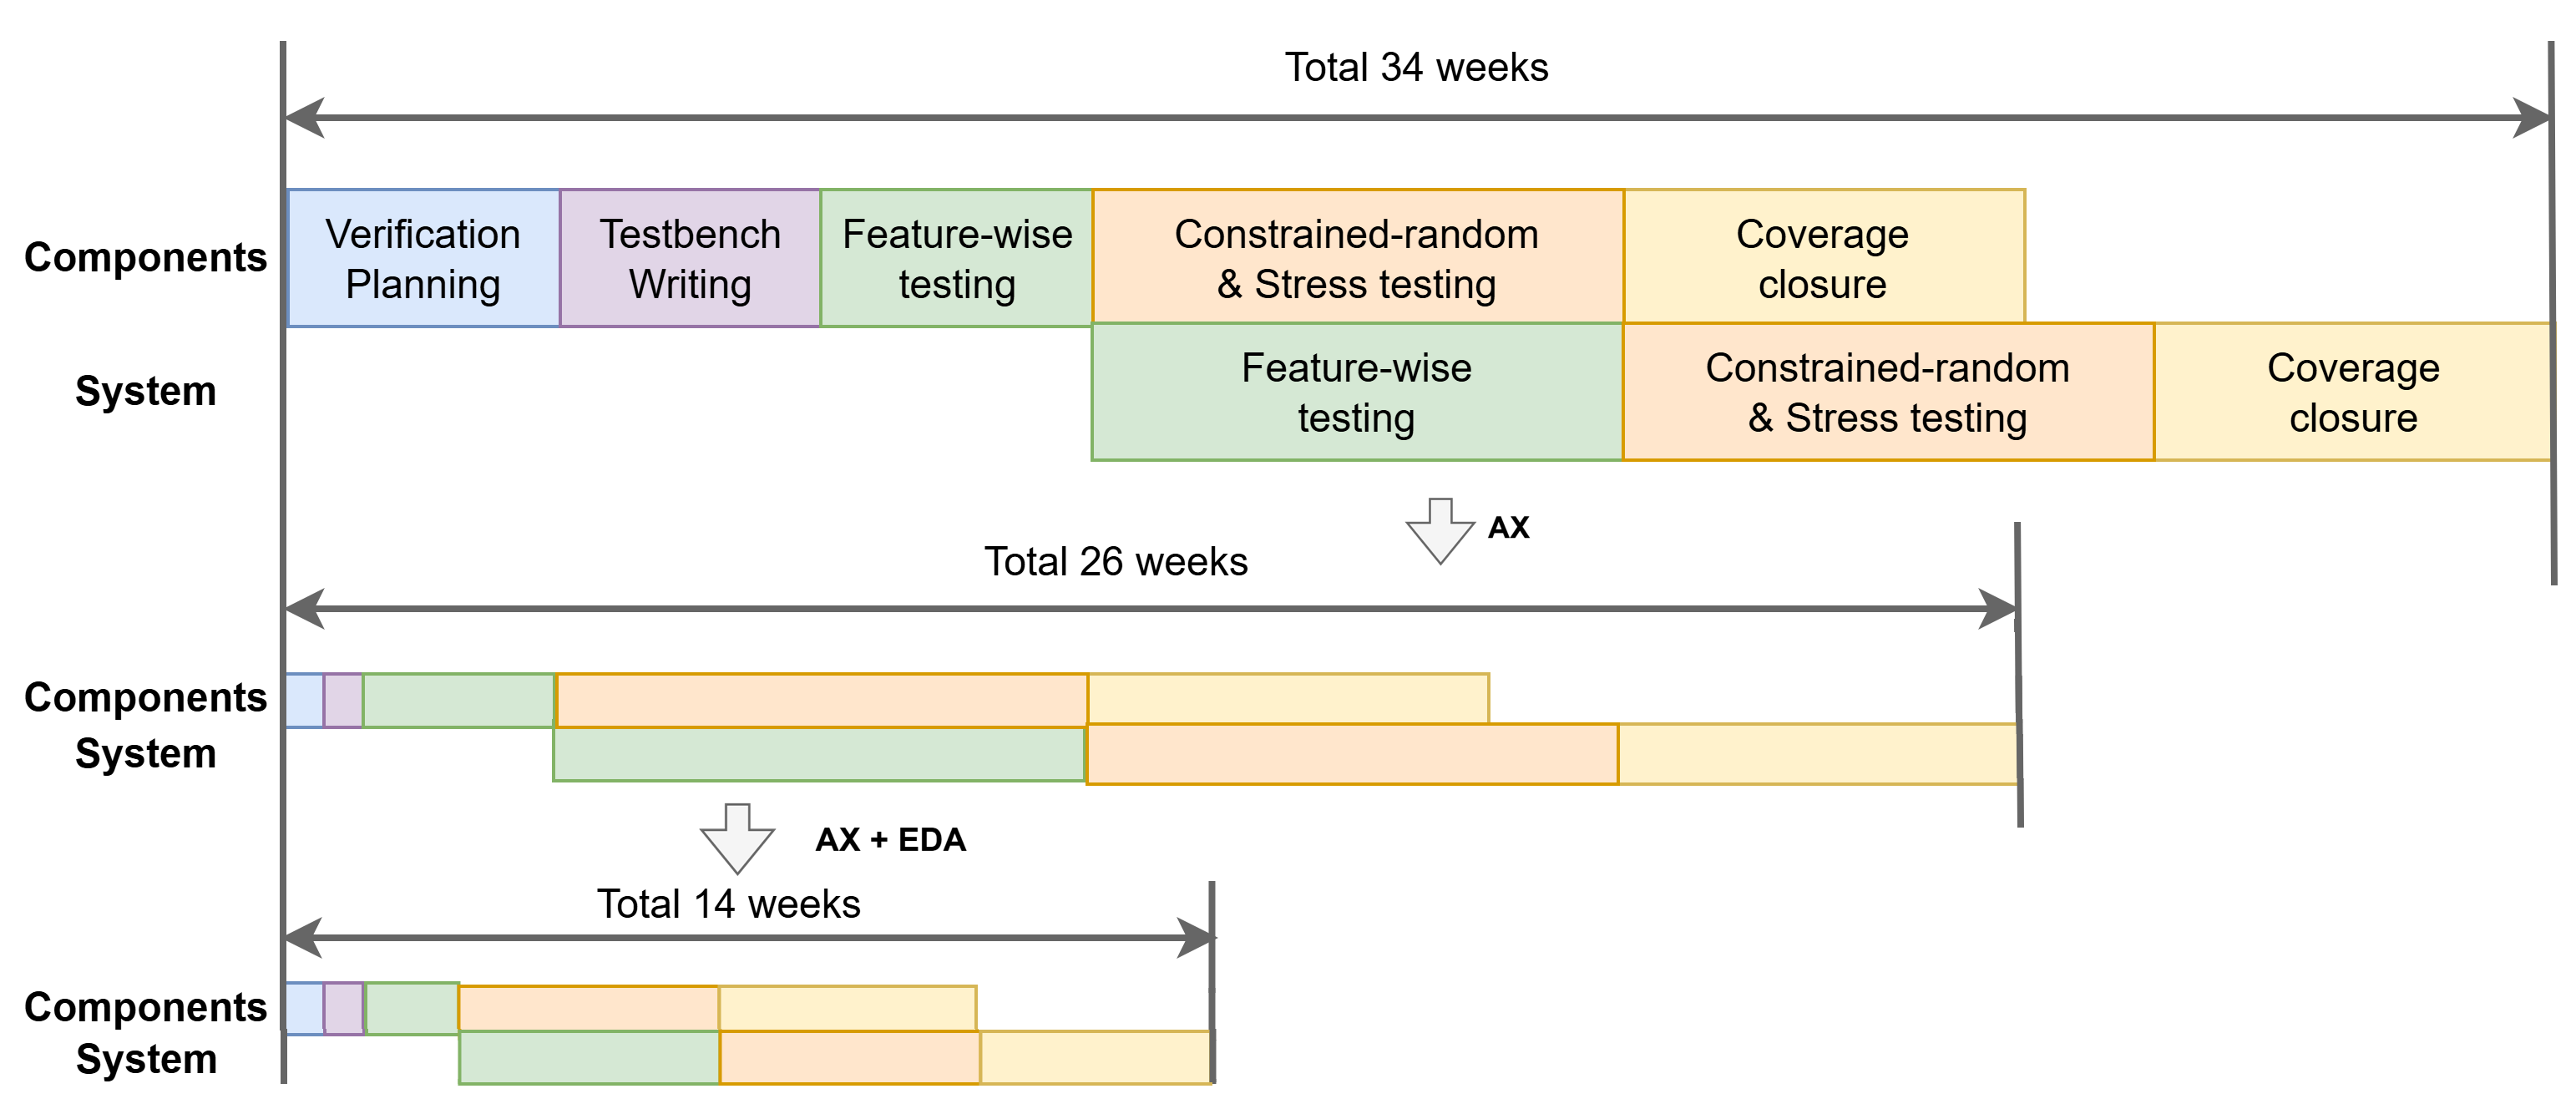
그림 1. AX와 EDA 실행 환경 개선에 따른 NPU 개발 기간 단축
EDA 워크로드에서 AWS가 제공하는 이점
온프레미스 EDA 팜은 프로젝트 시작 전에 컴퓨팅과 스토리지 수요를 예측해 장비를 구매해야 합니다. Rebellions가 신규 고성능 서버를 검토했을 때 발주 이후 최소 20주의 리드 타임이 필요했고, 설치와 실제 사용까지 고려하면 6개월에서 8개월을 기다려야 했습니다. 반면 EDA 수요는 full regression, DFT, Physical Design 등 특정 시기에 집중되므로 피크를 기준으로 장비를 구매하면 평상시에 유휴 자원이 발생하고, 평균 수요에 맞추면 중요한 시기에 작업 대기 시간이 길어집니다.
AWS에서는 프로세서 아키텍처와 CPU 성능, 메모리, 로컬 스토리지 및 네트워크 구성이 서로 다른 Amazon EC2 인스턴스 중 EDA 작업에 적합한 구성을 선택할 수 있습니다. 예를 들어 r8i는 Intel Xeon 6 프로세서와 대용량 메모리가 필요한 x86 기반 EDA 작업에 활용할 수 있습니다. c8g는 AWS Graviton4 프로세서를 탑재한 Arm 기반 인스턴스로, 사용 중인 EDA 소프트웨어와 관련 라이브러리가 Arm64를 지원한다면 보다 비용 효율을 높이는 선택지로 검토할 수 있습니다. x8aedz는 높은 단일 코어 성능과 대용량 메모리, 로컬 NVMe 스토리지가 필요한 Physical Design 및 대규모 EDA 작업에 적합한 선택지입니다. 이러한 인스턴스를 작업 특성에 따라 선택하고 필요한 시점에 확장하면, 서버의 구매/설치 시간을 줄이고 필요한 시점에 맞춰 실행 환경을 구성할 수 있습니다.
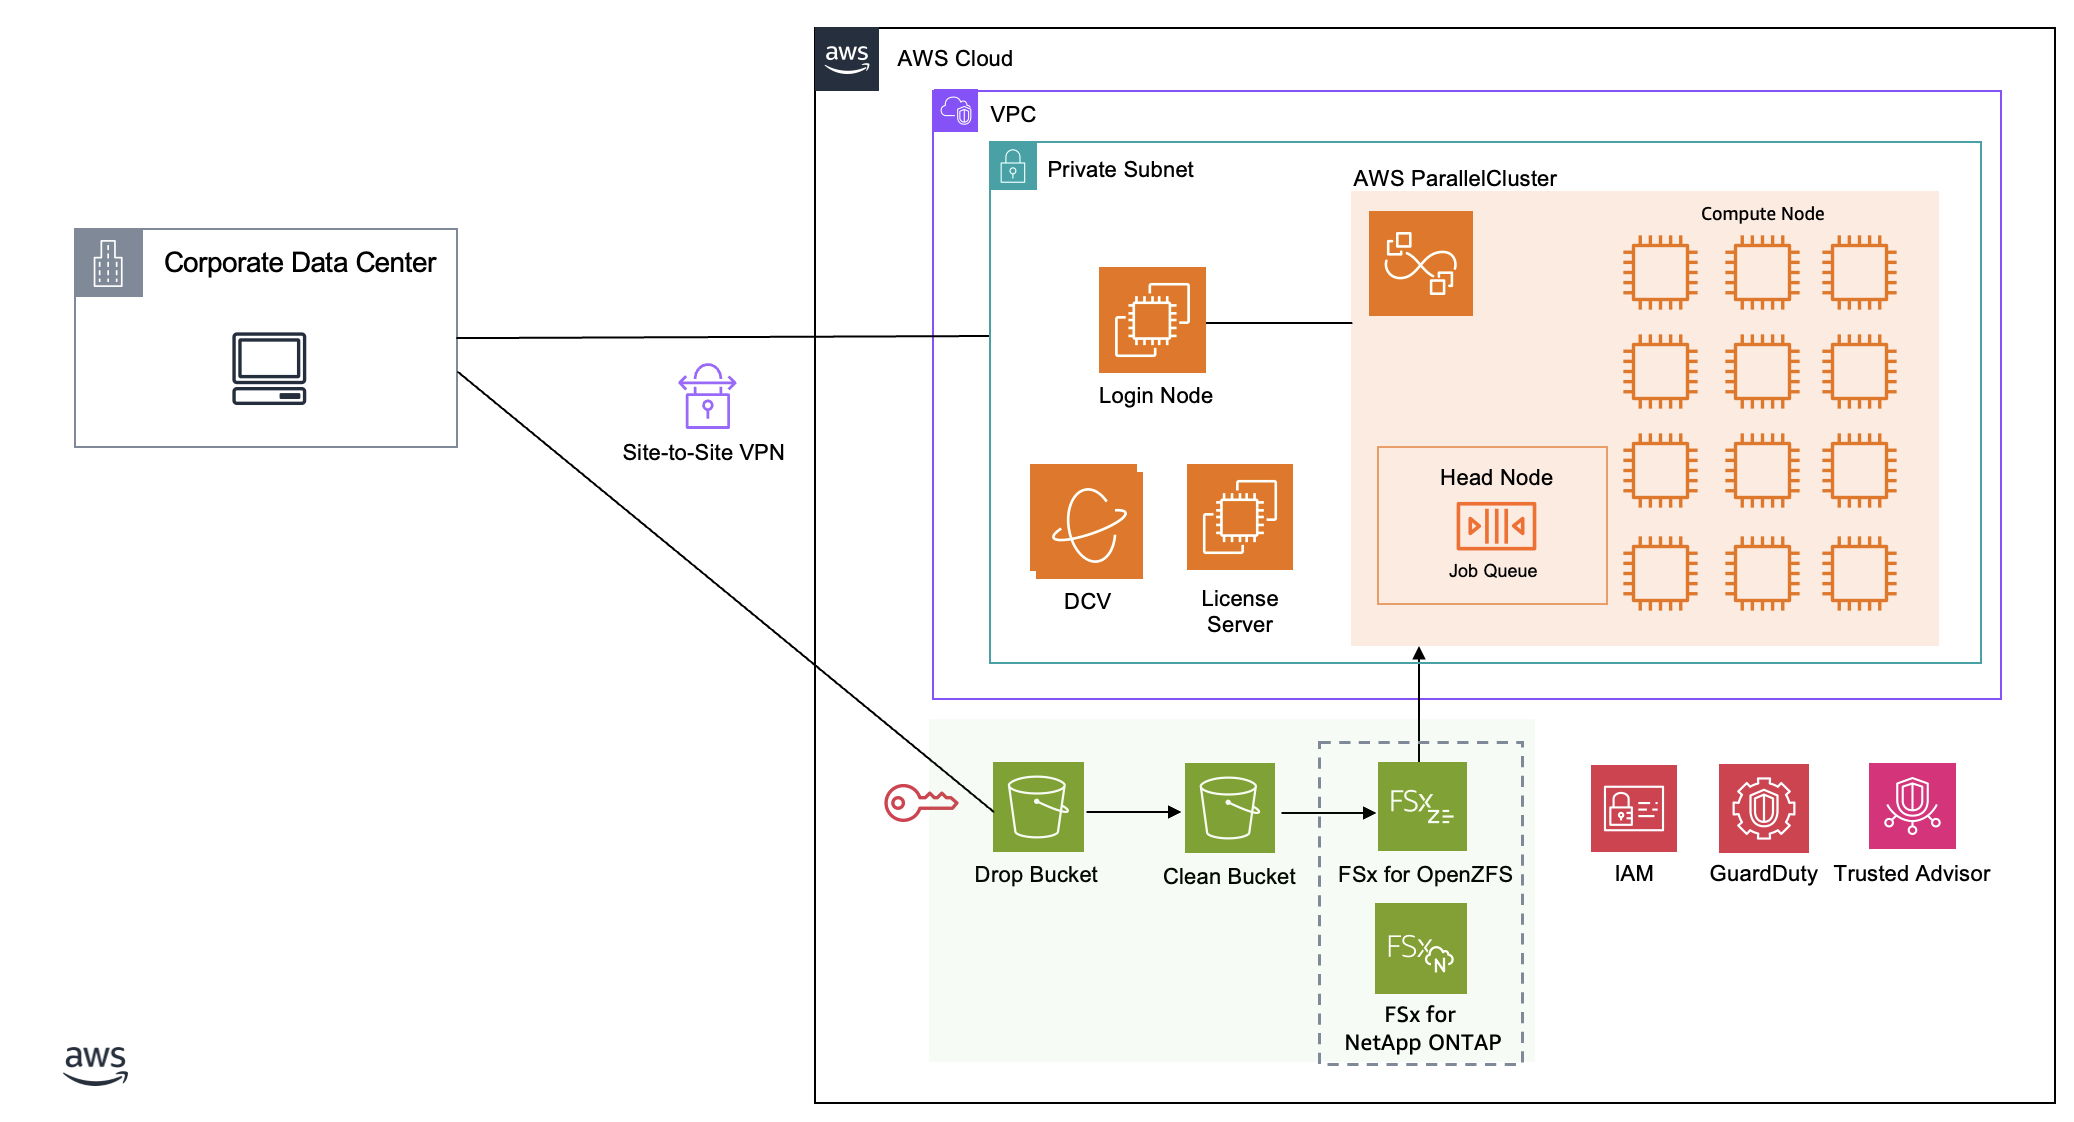
그림 2. AWS ParallelCluster와 Amazon FSx를 활용한 EDA 참조 아키텍처
AWS ParallelCluster는 Slurm 기반 EDA 클러스터의 구축과 관리를 단순화합니다. 사용자가 기존과 같은 방식으로 작업을 제출하면 대기 중인 작업에 맞춰 Amazon EC2 Compute Node를 생성하고, 작업이 완료된 뒤 유휴 노드를 축소합니다. Logic Simulation, DFT, Physical Design처럼 요구 사양이 다른 작업을 별도의 Slurm 큐와 EC2 구성에 연결할 수도 있습니다. 최소 Compute Node 수를 0으로 구성하면 full regression이나 설계 마일스톤에만 많은 컴퓨팅 자원을 사용하고 평상시에는 모든 Compute Node를 종료할 수 있습니다.
EDA 도구는 많은 소스 파일과 라이브러리를 읽고 로그, waveform 및 중간 결과를 반복적으로 기록합니다. 여러 Compute Node가 같은 데이터에 동시에 접근하므로 공유 스토리지의 처리량뿐 아니라 접근 지연 시간도 중요합니다. AWS에서는 EDA 워크로드 특성에 적합한 Amazon FSx for OpenZFS와 Amazon FSx for NetApp ONTAP 고성능 스토리지 옵션을 사용할 수 있습니다.
반도체 설계 파일은 기업의 핵심 자산이므로 클라우드 환경에서도 외부 유출을 방지할 수 있는 통제가 필요합니다. EDA 환경을 고객이 관리하는 AWS 계정과 VPC의 프라이빗 서브넷에 배치하고, 데이터센터에서는 AWS Site-to-Site VPN을 통해서만 접근하도록 구성하면 설계 파일과 컴퓨팅 환경을 인터넷에 노출하지 않습니다. IAM과 보안 그룹으로 허용된 사용자와 시스템만 접근하도록 제한하고 저장 데이터를 암호화하며, AWS CloudTrail로 사용자의 활동을 감사하며, Amazon CloudWatch Logs로 시스템과 작업 로그를 모니터링할 수 있습니다. 이를 통해 설계 파일을 통제된 네트워크와 권한 경계 안에서 관리하고 외부 유출에 대한 우려를 줄일 수 있습니다.
Rebellions가 적용한 EDA on AWS 아키텍처
Rebellions는 앞서 살펴본 AWS의 컴퓨팅과 스토리지 선택지 가운데 AWS ParallelCluster, Amazon EC2 x8aedz와 c8g 인스턴스 그리고 Amazon FSx for OpenZFS 스토리지를 이용해 검증 환경을 구성했습니다. Rebellions 데이터센터와 AWS VPC는 AWS Site-to-Site VPN으로 연결했습니다.
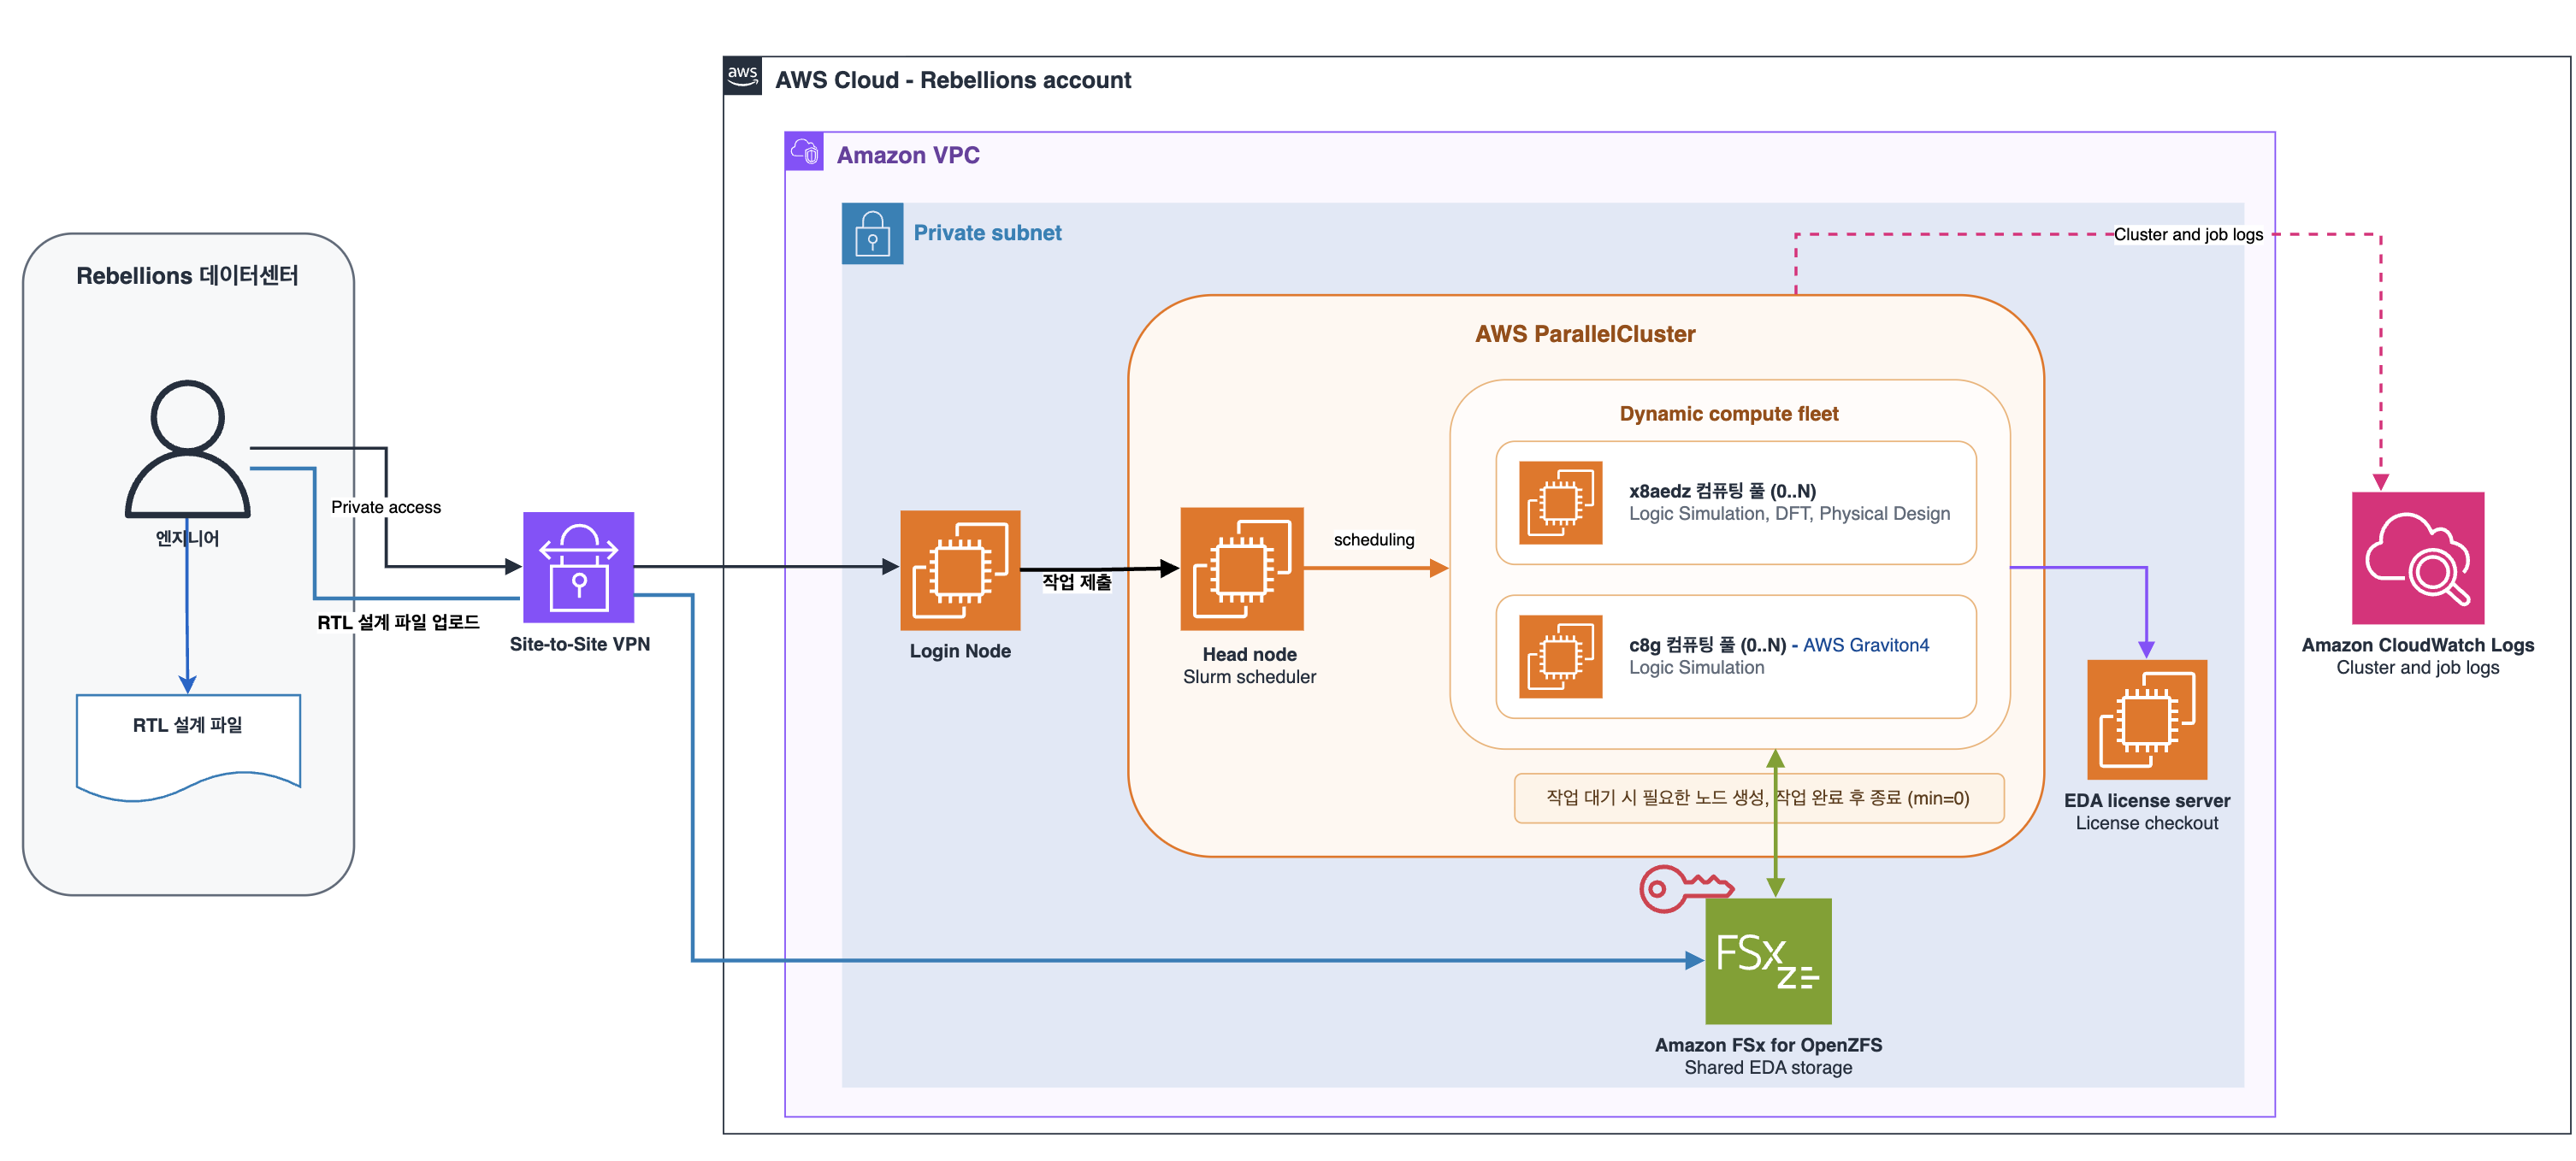
그림 3. Rebellions EDA on AWS 검증 아키텍처
EDA 엔지니어는 Site-to-Site VPN을 통해 AWS ParallelCluster의 Slurm 스케줄러에 작업을 제출하고, 데이터센터의 RTL 설계 파일을 Amazon FSx for OpenZFS에 업로드합니다. 대기 작업이 발생하면 필요한 Amazon EC2 x8aedz 컴퓨팅 노드가 생성되어 Logic Simulation, DFT 및 Physical Design 작업을 실행합니다. 작업을 완료하고 유휴 상태가 되면 모든 컴퓨팅 노드는 종료되며, Head node와 Amazon FSx for OpenZFS, EDA 라이선스 서버는 유지됩니다. 컴퓨팅 노드에서는 FSx for OpenZFS 고성능 스토리지를 마운트해 EDA 도구와 설계 데이터, 작업 공간 및 결과를 공유하고, 클러스터와 작업 로그는 Amazon CloudWatch Logs에서 확인할 수 있습니다.
파일 액세스 성능 비교
EDA 작업은 소스 코드와 라이브러리뿐 아니라 대량의 로그, waveform, 중간 산출물에 반복적으로 접근합니다. 특히 많은 작업이 동시에 실행될 때 공유 파일 시스템과 네트워크의 처리량 및 지연 시간이 전체 처리량을 제한할 수 있습니다.
Rebellions는 실제 EDA 작업을 실행하기 전에 온프레미스 NFS와 AWS 저장소 시스템에 대한 파일 액세스 성능을 비교했습니다.
| 항목 | Rebellions 온프레미스 NetApp C400A, 40G Ethernet |
AWS EC2 FSx for OpenZFS, 75G Ethernet |
성능 개선 배수 |
|---|---|---|---|
| 순차 쓰기 | 108MB/s | 855MB/s | 약 7.9배 |
| 순차 읽기 | 67MB/s | 1,229MB/s | 약 18.3배 |
| 병렬 쓰기 (4개 스트림 동시) | 112MB/s | 1,134MB/s | 약 10.1배 |
| 4KB 랜덤 접근 지연 시간 | 2.98ms | 0.10ms | 약 29.8배 |
AWS 환경은 순차 쓰기에서 약 7.9배, 순차 읽기에서 약 18.3배, 4개 스트림 병렬 쓰기에서 약 10.1배 높은 처리량을 보였습니다. 4KB 랜덤 접근 지연 시간은 약 30분의 1로 측정됐습니다.
이러한 차이에는 스토리지 자체의 성능뿐 아니라 네트워크 대역폭과 자원 할당 방식도 영향을 미쳤습니다. 온프레미스 환경에서는 10Gbps 이더넷 4회선을 여러 컴퓨팅 서버가 공유해 개별 서버가 최대 10Gbps의 대역폭을 사용한 반면, AWS 환경에서는 개별 Amazon EC2 인스턴스가 최대 75Gbps의 네트워크 대역폭을 제공받아 7배 이상의 대역폭을 활용할 수 있었습니다. 또한 온프레미스 스토리지는 전사가 공유하는 자원이었지만, Amazon FSx for OpenZFS는 이번 EDA 워크로드에 전용으로 할당되어 다른 워크로드의 I/O 영향을 받지 않았습니다.
단일 Logic Simulation 작업이 CPU 중심이라면 스토리지 처리량이 10배 증가하더라도 애플리케이션 실행 시간이 같은 비율로 단축되지는 않습니다. 공유 스토리지의 장점은 다수의 작업이 동시에 데이터를 읽고 로그와 결과를 쓸 때 더 분명하게 나타납니다.
Logic Simulation 성능 비교
Logic Simulation은 반도체를 제조하기 전에 RTL(Register Transfer Level)로 작성한 회로가 의도한 대로 동작하는지 소프트웨어로 검증하는 작업입니다. 검증해야 하는 설계 회로 로직(RTL)마다 수 분에서 수십 시간의 실행이 필요한 수만 개의 테스트를 수십 회 반복해야 합니다.
이번 비교에서는 EDA 도구로 Synopsys VCS를 사용했으며, Rebellions 보유 온프레미스 서버(Intel Xeon Processor 기반)의 물리 코어 수에 맞춰 최대 64개의 작업을 동시에 실행했습니다. EC2에서는 다양한 CPU와 메모리 구성의 인스턴스를 제공하므로, 워크로드 특성에 맞는 구성을 선택할 수 있습니다. 이번 실험에서는 다수의 물리 코어와 높은 단일 코어 성능, 대용량 메모리를 함께 갖춘 x8aedz 컴퓨팅 노드(AMD EPYC 9R45 기반)와 비용 효율성이 높은 c8g 컴퓨팅 노드(AWS Graviton4 기반)의 결과를 비교했습니다.
테스트한 UCIE IP와 Network-on-Chip 워크로드 모두에서 AWS 환경은 온프레미스 환경보다 일관되게 짧은 실행 시간을 보였습니다. 동시 작업 수가 1개, 16개, 32개, 64개로 증가하는 동안 AWS x8aedz 컴퓨팅 노드에서의 시뮬레이션 시간은 온프레미스 대비 2.3배에서 2.6배 빠르게 완료되었으며, AWS c8g 컴퓨팅 노드에서도 약 1.3배 빠르게 완료되었습니다.
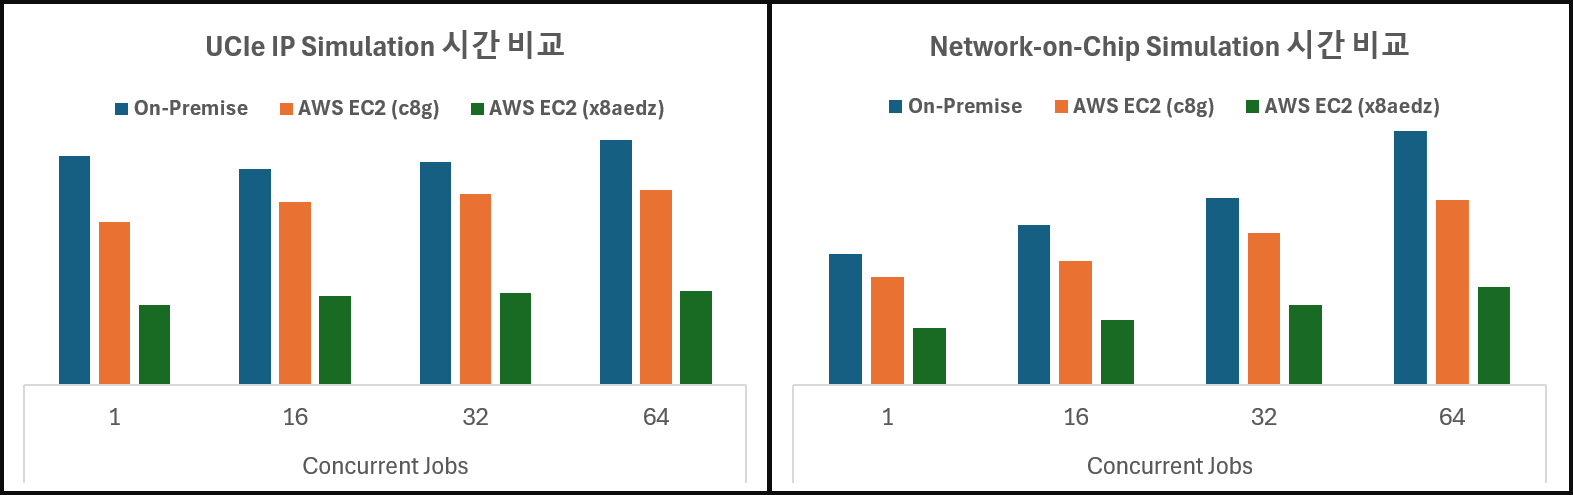
그림 4. UCIE IP와 Network-on-Chip Logic Simulation 성능 비교
Logic Simulation에는 Synopsys VCS®와 같은 상용 시뮬레이터 라이선스가 필요하므로, 컴퓨팅 자원과 라이선스 수량의 균형점을 맞추는 것이 중요합니다. 국내외 대기업과 같이 Site Licensing을 한 경우에는 서버(CPU core)의 개수를 많이 늘려 Simulation Throughput을 확보하는 것도 방법이겠으나, 반면 제한된 수의 라이선스를 운용하는 스타트업은 높은 단일 코어 성능으로 개별 작업 시간을 줄여 보유한 라이선스를 효율적으로 활용하는 접근이 필요합니다.
따라서 Logic Simulation 환경은 라이선스 수량과 작업 특성에 맞춰 컴퓨팅 자원을 선택해야 합니다. AWS에서는 높은 단일 코어 성능, 많은 CPU 코어, 대용량 메모리, 로컬 NVMe 스토리지 등 서로 다른 특성을 제공하는 다양한 Amazon EC2 인스턴스를 선택할 수 있습니다. 이를 통해 개별 시뮬레이션의 실행 속도와 대규모 병렬 작업의 처리량을 고려해 적합한 컴퓨팅 구성을 사용하고, 필요한 시점에만 확장할 수 있습니다.
Design for Test (DFT) 설계 성능 비교
DFT는 제조된 칩의 결함을 검사할 수 있도록 진단 회로를 설계에 삽입하는 과정입니다. 수많은 회로에서 발생할 수 있는 다양한 결함을 짧은 시간 안에 검출하면서도 칩의 기능과 성능에 미치는 영향을 최소화해야 하므로 높은 CPU 부하와 스토리지 I/O가 발생합니다.
이번 실험에서는 R100의 Neural Core와 Shared Memory를 대상으로 Synopsys TestMAX를 사용했습니다. 작업의 전체 실행 시간을 합하면 온프레미스에서는 11시간 51분, AWS x8aedz 컴퓨팅 노드에서는 4시간 41분이 걸렸습니다. 동일한 작업 묶음을 기준으로 AWS 환경이 약 2.5배 빠르게 완료했습니다.
| DFT 대상 | 작업 유형 | 온프레미스 | AWS x8aedz | 성능 배수 |
|---|---|---|---|---|
| Neural Core | Memory Built-in Self Test | 4시간 44분 | 1시간 54분 | 약 2.5배 |
| Neural Core | Scan Insertion | 1시간 40분 | 38분 | 약 2.6배 |
| Shared Memory | Memory Built-in Self Test | 2시간 26분 | 1시간 16분 | 약 1.9배 |
| Shared Memory | Scan Insertion | 3시간 1분 | 53분 | 약 3.4배 |
Physical Design 성능 비교
Physical Design은 코드로 작성된 반도체 설계도인 RTL로부터 파운드리에서 제조할 물리적 회로 레이아웃 데이터인 GDSII를 만드는 과정입니다. 세부적으로는 논리 합성(RTL Synthesis), Floor Planning과 Placement, Clock Tree Synthesis, Routing, Timing 및 Power Optimization 등 매우 복잡한 단계로 구성됩니다.
Physical Design은 그 자체로 CPU 부하와 메모리 요구량이 많은 작업이며, 여기에 사용되는 EDA 도구 라이선스는 설계 인프라에서 가장 비중이 큰 투자 항목입니다. 따라서 EDA 도구를 효율적으로 활용하고 한 번의 실행 시간을 단축하려면 고성능 CPU를 확보하는 것이 매우 중요합니다. 이번 실험에서도 R100의 Neural Core를 대상으로 Synopsys Fusion Compiler™를 사용해 성능을 비교했습니다.
| 작업 유형 | 온프레미스 | AWS x8aedz | 성능 배수 |
|---|---|---|---|
| Logic Synthesis | 101시간 | 54시간 | 약 1.9배 |
| Clock Tree Synthesis | 75시간 | 34시간 | 약 2.2배 |
| Route | 90시간 | 41시간 | 약 2.2배 |
| 합계 | 266시간 | 129시간 | 약 2.1배 |
온프레미스 환경에서는 전체 과정에 266시간이 걸렸지만 AWS 환경에서는 129시간에 완료했습니다. 약 11일이 걸리던 한 번의 실행을 약 5.4일로 줄여 전체 시간을 약 2.1배 단축했습니다.
이번 결과는 고성능 CPU와 대용량 메모리를 갖춘 AWS 컴퓨팅 환경을 활용하면 장시간 실행되는 Physical Design의 반복 주기를 줄이고, EDA 도구를 더욱 효율적으로 활용할 수 있음을 보여줍니다.
검증 결과가 보여주는 것
이번 테스트에서는 다음 결과를 확인했습니다.
- 파일 접근 성능은 항목에 따라 약 7.9배에서 18.3배 높은 처리량을 보였고, 4KB 랜덤 접근 지연 시간은 약 30분의 1로 측정됐습니다.
- Logic Simulation은 1개에서 64개 동시 작업 조건에서 2.3배에서 2.6배 빠르게 완료했습니다. AWS Graviton Processor을 통해 비용 효율성을 높인 c8g 인스턴스에서는 1.2~1.4배 빠르게 완료했습니다.
- DFT 작업은 11시간 51분에서 4시간 41분으로 줄어 약 2.5배 빠르게 완료했습니다.
- Physical Design은 266시간에서 129시간으로 줄어 약 2.1배 빠르게 완료했습니다.
이 결과는 최신 프로세서와 대용량 메모리, 고대역 네트워크, 독립적으로 할당한 공유 스토리지가 결합된 테스트 환경의 효과입니다. 어느 하나의 서비스만으로 전체 개선을 설명할 수는 없습니다.
더 중요한 변화는 개발 수요가 발생한 시점에 많은 컴퓨팅 자원을 집중적으로 투입할 수 있다는 점입니다. Logic Simulation의 대규모 작업 대기열에는 여러 컴퓨팅 노드를 동시에 확장하고, Physical Design에는 높은 클록과 대용량 메모리를 갖춘 인스턴스를 할당할 수 있습니다. 작업이 끝난 뒤 동적 컴퓨팅 노드를 축소하면 짧은 피크 수요를 위해 같은 규모의 서버를 상시 보유할 필요도 줄어듭니다.
비용을 평가하는 세 가지 관점
클라우드와 온프레미스의 비용은 시기와 계약, 운영 방식에 따라 달라지므로 단순한 서버 가격만으로 비교하기 어렵습니다. 여기서는 구체적인 비용 수치를 단정하기보다 Rebellions가 EDA 환경을 검토하며 고민한 세 가지 기준을 살펴봅니다.
우선 개발 시작 시점에 맞춰 최상급 서버를 도입하는 것은 쉽지 않습니다. 신규 서버를 선정하고 발주하면 최소 20주의 리드 타임이 필요하고, 배송과 설치를 거쳐 실제로 사용하기까지 6개월에서 8개월을 기다려야 합니다. 개발 일정에 맞추려면 최소 6개월 전에 장비를 발주해야 하는 셈입니다. 장비가 예정대로 도입됐더라도 개발 시작이 6개월 늦어진다면 어떻게 될까요? 실제 개발에서는 한 세대 이전 서버를 사용하게 될 수 있습니다. AWS에서는 개발이 시작되는 시점에 사용할 수 있는 최신 세대의 고성능 CPU를 선택하고, 필요한 규모의 컴퓨팅 자원을 과제에 맞춰 구성할 수 있습니다.
다음으로 스타트업에서 온프레미스를 도입할 때에는 모든 워크로드의 최대 요구량을 고려하여 CPU 성능, 메모리 크기, 스토리지를 선정하게 되는데, 이 때문에 각 EDA Job 별로는 불필요한 리소스를 활용하는 비효율이 있습니다. 온프레미스 환경에서는 여러 EDA 워크로드의 최대 요구 사양을 고려해 서버를 도입해야 하므로, 작업에 따라 자원이 비효율적으로 사용될 수 있습니다. 예를 들어 Physical Design 작업에는 약 400GB~1TB의 대용량 메모리가 필요합니다. 이에 따라 Rebellions가 도입한 온프레미스 서버는 모두 3TB 메모리를 탑재하고 있으며, 개발 전반부에는 Simulation, 후반부에는 Physical Design에 활용하고 있습니다. 반면 Simulation Job의 경우 IP는 2GB~30GB 정도의 메모리만 필요하므로, 개발 전반부에서는 리소스를 비효율적으로 활용하는 셈입니다. 스토리지 비용도 고려해야 합니다. Rebellions가 검토한 최신형 500TB급 스토리지는 10억원에서 20억원 수준이었습니다. 스토리지는 평균 사용량과 피크 사용량의 차이가 크지만, 온프레미스에서는 피크를 기준으로 고성능 대용량 시스템을 미리 구축해야 합니다. 예상한 피크 용량이나 성능을 초과하면 실행 중인 EDA 작업이 중단되는 심각한 문제가 발생할 수도 있습니다. 반면 AWS 기반 컴퓨팅 클러스터에서는 스토리지에 대한 대규모 초기 투자를 줄이고, 실제 사용 패턴에 맞춰 적합한 CPU와 필요한 스토리지 용량을 구성할 수 있습니다.
마지막으로 EDA 도구의 활용도도 함께 평가해야 합니다. 고성능 EDA 도구를 낮은 성능의 서버에서 장시간 실행하면 라이선스를 충분히 활용하기 어렵습니다. 따라서 EDA 환경의 비용은 컴퓨팅 자원의 시간당 단가만이 아니라, 고성능 컴퓨팅 환경에서 완료한 작업 수와 단축한 실행 시간, 라이선스 활용 효율을 기준으로 평가해야 합니다.
맺음말 – 진정한 개발의 가속화
AX를 통해 테스트 생성과 분석 등 엔지니어의 업무 효율을 크게 높이더라도, EDA 도구를 실행하는 시간이 병목으로 남아 있다면 전체 개발 기간을 단축하는 데에는 한계가 있습니다. 소프트웨어 개발 방식의 혁신과 이를 뒷받침하는 컴퓨팅 인프라가 함께 개선되어야 하는 이유입니다.
Rebellions는 실제 NPU 개발 워크로드를 AWS에서 검증해 Logic Simulation, DFT, Physical Design의 실행 시간을 줄이고, 공유 스토리지의 파일 접근 성능을 높일 수 있음을 확인했습니다. 또한 최신 클라우드 컴퓨팅 인프라가 긴 서버 조달 리드 타임과 피크 수요에 맞춘 스토리지 과투자 등 온프레미스 환경의 한계를 보완할 수 있는 현실적인 대안임을 확인했습니다.
AWS 기반 EDA 환경의 가치는 단순히 더 빠른 서버 한 대를 사용하는 데 있지 않습니다. 작업 특성에 맞는 컴퓨팅과 스토리지를 선택하고, regression과 설계 마일스톤에 대규모 자원을 집중적으로 투입한 뒤 작업이 끝나면 다시 축소할 수 있다는 점에 있습니다. 이를 통해 고정된 인프라 용량 때문에 발생하는 작업 대기 시간을 줄이고 설계 반복 결과를 더 빠르게 확보할 수 있습니다.
Rebellions는 AX를 통한 소프트웨어 혁신과 AWS의 탄력적인 컴퓨팅 인프라가 만드는 시너지를 바탕으로 차세대 AI NPU의 개발을 더욱 가속하여 글로벌 시장에 경쟁력 있는 AI 추론 솔루션을 빠르게 선보이겠습니다.
참고 자료
- Rebellions
- Rebellions – R100
- AWS ParallelCluster
- Amazon FSx for OpenZFS
- Amazon FSx for NetApp ONTAP
- Amazon EC2 x8aedz Instance
- Amazon Graviton Processor