AWS Glue
发现、准备和集成所有任意规模的数据
为什么选择 AWS Glue?
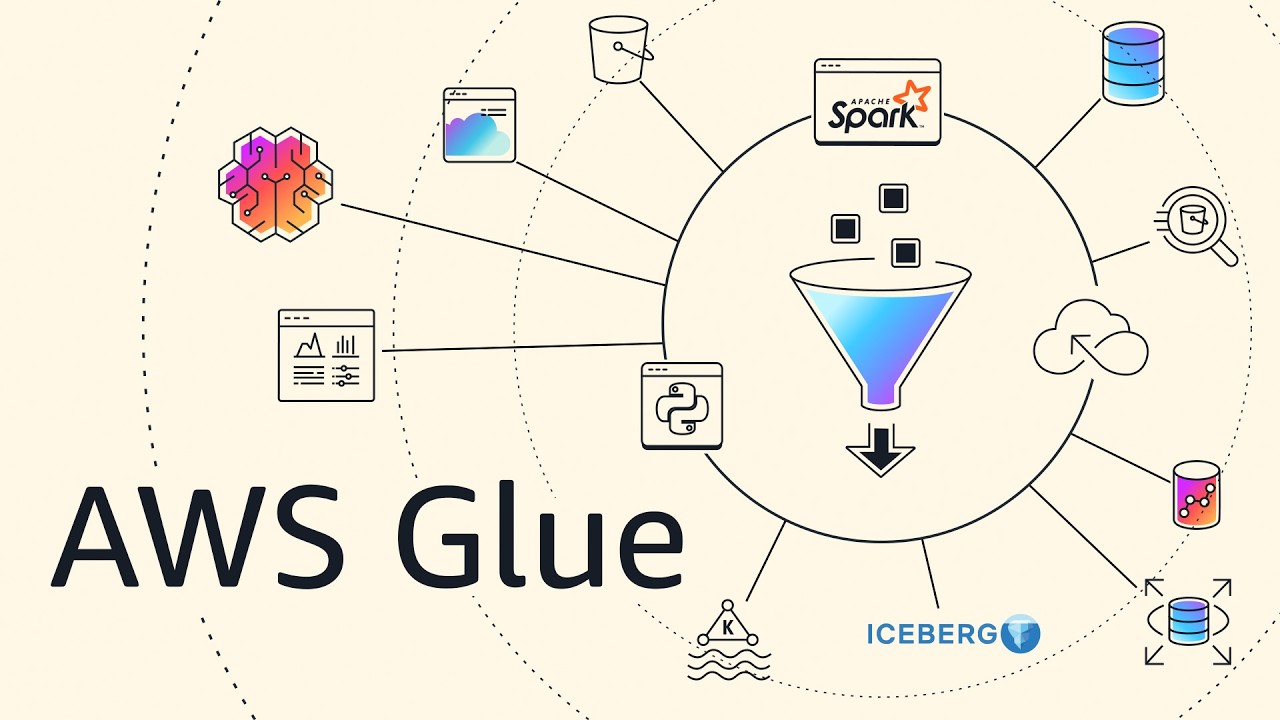
AWS Glue 是一项无服务器数据集成服务,可让您更简单、更快速、更经济地发现、准备并整合数据,用于分析、AI 和代理。连接到 100 多种不同的数据来源,在集中式目录中管理数据,并以可视化方式创建、运行和监控数据管道,将数据加载到数据湖、数据仓库和湖仓一体架构中 — 全程无需管理基础设施。AWS 在 2025 年 Gartner 数据集成工具魔力象限中被评为领导者。
在 Amazon SageMaker 中利用 AWS Glue 集成数据
借助下一代 Amazon SageMaker 中的 AWS Glue,您可以通过经济实惠、无服务器和可扩展的数据集成,在一个位置集中管理并构建工作负载。
优势
AWS Glue 提供数据集成所需的所有功能,可帮助您快速获取见解。这一完全托管的无服务器工具包包含内置 ETL、自动架构发现、集中式数据目录以及跨服务集成功能。
Spark 声明式管道无需编写数百行用于编排的样板代码。您只需声明转换逻辑,引擎便会自动处理执行顺序、依赖关系、错误处理和检查点设置。结合生成式人工智能辅助的代码生成和人工智能驱动的 Spark 作业现代化功能,您可以以前所未有的速度构建并交付数据管道。
AWS Glue 可自动扩展以处理从 GB 级到 PB 级的数据,即使是要求最苛刻的数据处理作业也能轻松应对,且无需管理基础设施。无需预置、配置或维护服务器 — 您只需为实际使用的资源付费,按秒计费,且无需前期投入。
原生支持 Arrow 的 Python UDF 和 UDTF 省去了序列化开销,可显著提升复杂 PySpark 转换任务的性能,且无需更改代码。
连接数百种多样化的数据来源,无缝集成来自数据库、数据仓库、数据湖及 SaaS 应用程序的数据。借助开源 Apache Spark、Python 和 Scala 构建 ETL 作业。您的代码可在任何支持 Spark 的环境中运行,从而确保灵活性并避免供应商锁定。与 Amazon Athena、Amazon EMR、Amazon Redshift 和 Amazon SageMaker 无缝集成。
基于 Apache Spark 4.1.1 构建(支持 Python 3.12 和 Scala 2.13),并同时支持 Iceberg 1.10.0、Hudi 1.1.1 和 Delta Lake 4.0.0。全面支持 Apache Iceberg v3,包括用于空间分析的几何/地理类型、纳秒级精度时间戳,以及支持稳健模式演进的未知类型处理功能。
AWS Glue 充当机器学习和 AI 代理的数据准备与集成核心,确保它们能大规模获取干净、及时且结构良好的数据。将 Glue 的 ETL 能力与 Amazon SageMaker 相结合,构建端到端机器学习工作流。
Glue 中的 Iceberg v3 VARIANT 拆解功能针对 JSON、日志和事件流等半结构化数据(这些正是机器学习特征管道和 AI 训练数据集的主要数据源)实现了更快的读取速度和更简便的模式管理。
使用案例
数据湖摄取
使用最新的开放数据标准,将来自 100 多个源的数据摄取到您的数据湖中。Glue 对 Iceberg v3 的支持能够妥善处理架构演变,包括对未知类型的处理、针对物联网和金融数据的纳秒级时间戳,以及针对空间工作负载的几何类型支持。
ETL 管道现代化
用 Spark 声明式管道取代脆弱且需手动编排的管道 — 只需定义您想要的结果,无需指定具体的运行方式。利用生成式人工智能实现旧版 Spark 作业的现代化,并以极低的工作量迁移至 Glue。
实时分析
在同一 Glue 环境中(该环境也用于批处理),即可实现交易时的欺诈检测、实时个性化体验以及物联网异常警报。实时模式可提供个位数毫秒级的延迟,且无需单独的流处理基础设施。
机器学习数据准备
构建可扩展的数据准备管道,为机器学习模型和人工智能代理提供干净、结构化的数据。VARIANT 拆解技术能更快速地处理半结构化训练数据,无需进行扁平化处理或创建重复副本。
数据质量与治理
利用 Glue Data Catalog 集中管理元数据,通过爬网程序(Crawler)自动发现架构,并借助与 Lake Formation 的原生集成来实施治理。架构注册表支持针对流数据的 AVRO、JSON 和 Protocol Buffers 格式。
半结构化数据处理
利用 Iceberg VARIANT 原生存储和查询 JSON、日志、事件流及物联网遥测数据,无需使用单独的半结构化数据库。此前需要在多个系统中维护重复副本的组织现在可以整合到一个基于 Iceberg 的统一架构中。
新增内容
Stifel Financial
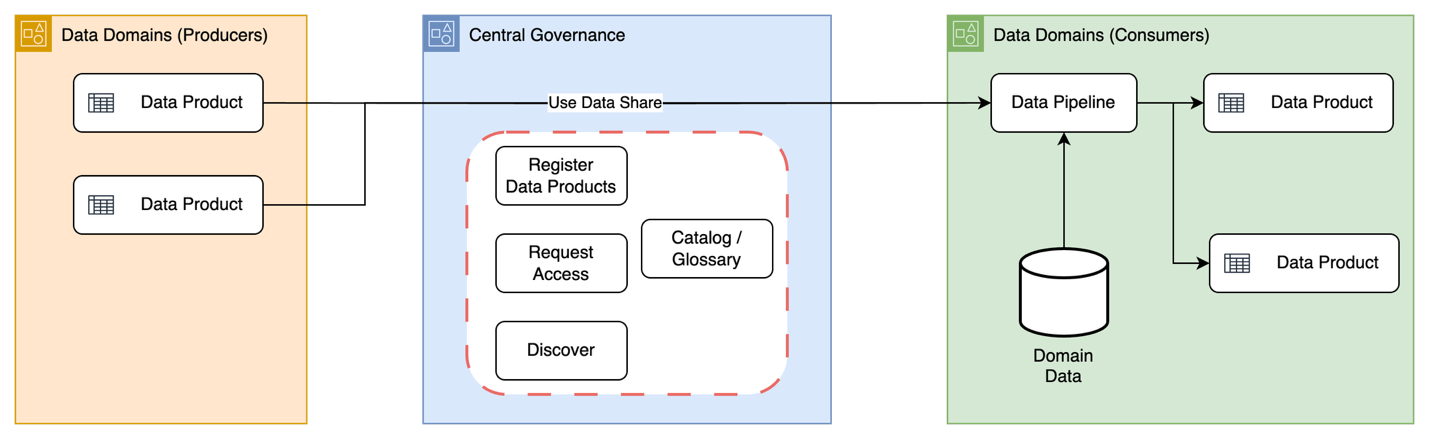
利用 AWS Glue 和开放数据标准构建了现代数据平台,采用事件驱动架构来支持领域数据产品,同时集中管理元数据以便于发现和共享。
BMW
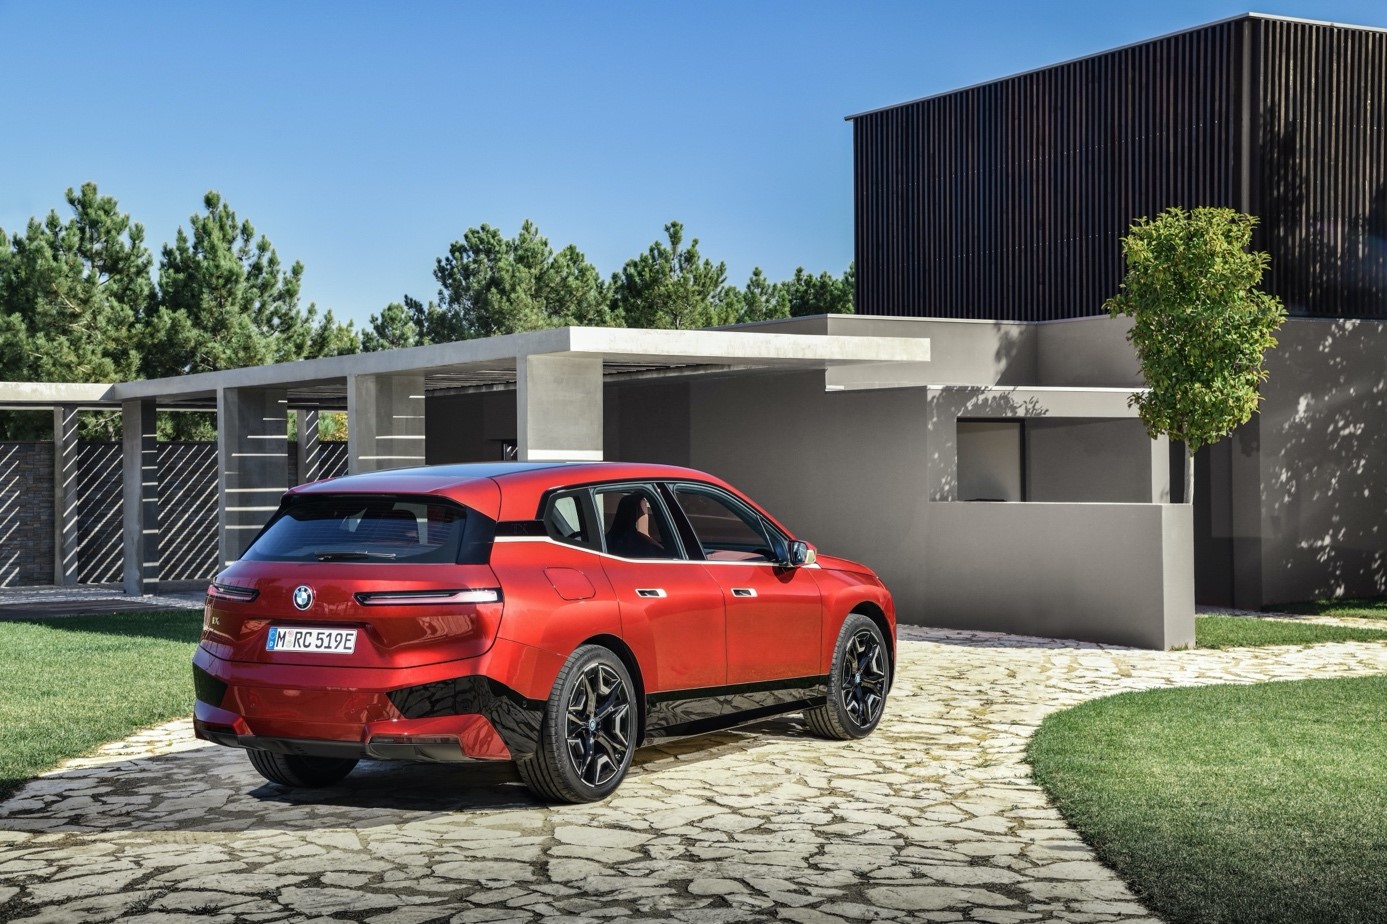
每天处理来自 120 万辆汽车的 10 TB 数据,打造语音控制的车载助手,并从车辆及客户遥测数据中获取实时洞察。
“为了保持创新,我们专注于创造全新的数字化互联体验,并通过赋能数据驱动的决策,推动价值链变革,从而提升效率与成效。”
— Kai Demtröder,宝马数据转型、AI、数据和 DevOps 集团副总裁
Stifel Financial
利用 AWS Glue 和开放数据标准构建了现代数据平台,采用事件驱动架构来支持领域数据产品,同时集中管理元数据以便于发现和共享。
找到今天要查找的内容了吗?
请提供您的意见,以便我们改进网页内容的质量